
Как найти коэффициент корреляции в Excel
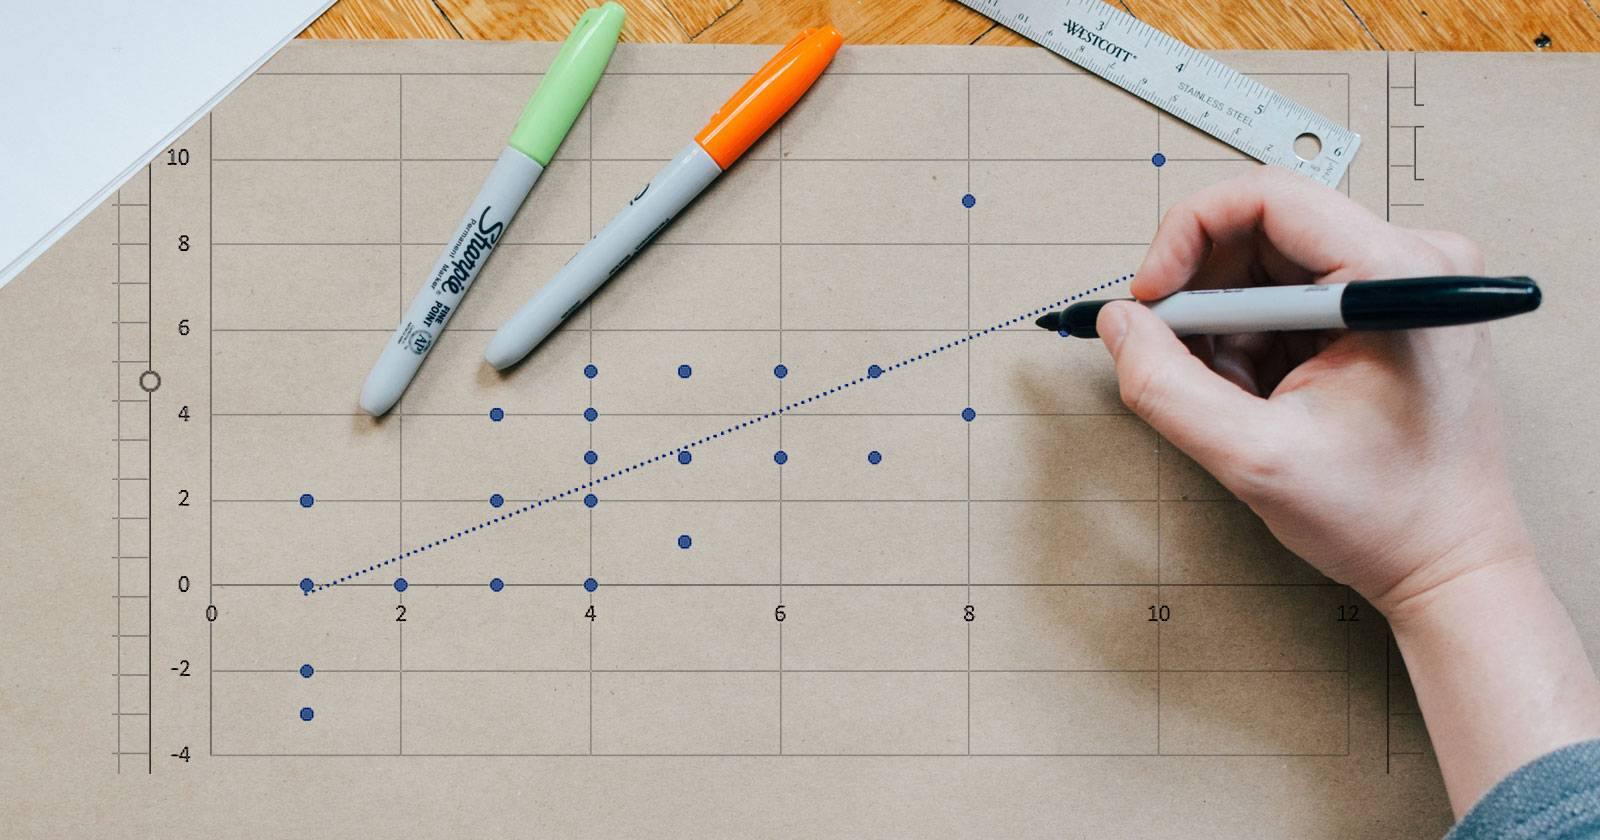

О чём эта статья
В этой статье вы узнаете:
- Что такое корреляция и как интерпретировать коэффициент корреляции.
- Как быстро посчитать коэффициент корреляции в Excel с помощью функции CORREL и с помощью надстройки «Анализ данных».
- Как визуализировать корреляцию на графике и добавить трендлайн.
- Отличие корреляции от линейной регрессии и когда нужен регрессионный анализ.
- Практические советы, ошибки и проверочные списки для аналитиков.
Важно: материал ориентирован на практическое применение; математические доказательства опущены в угоду понятным шагам и чек-листам.
Что такое корреляция?
Корреляция — это числовая мера степени линейной связи между двумя переменными. Проще: насколько предсказуемо меняется одна переменная при изменении другой.
- Корреляция не доказывает причинно-следственную связь. Она показывает только направление и силу линейной взаимосвязи.
- Корреляция измеряется коэффициентом в диапазоне от −1 до +1.
На рисунке выше точки распределены случайно — корреляции нет.
На этом рисунке наблюдается положительная корреляция: по мере увеличения X увеличивается и Y.
Понимание коэффициента корреляции
Коэффициент корреляции (обычно обозначают r) интерпретируется так:
- r = 1: идеальная положительная линейная зависимость (все точки точно на прямой с положительным наклоном).
- r = −1: идеальная отрицательная линейная зависимость (все точки точно на прямой с отрицательным наклоном).
- r = 0: отсутствие линейной зависимости.
- Значение между 0 и ±1 показывает степень силы линейной связи: чем ближе к ±1, тем сильнее.
Замечание о нелинейных взаимосвязях: сильная нелинейная зависимость может давать r ≈ 0, хотя переменные тесно связаны. Пример — парабола или синусоида:
Если форма взаимосвязи не линейна, используйте другие меры (ранговая корреляция Спирмена, нелинейное моделирование и т. п.).
Как найти коэффициент корреляции в Excel с помощью CORREL
В Excel есть встроенная функция для вычисления коэффициента корреляции. Синтаксис прост:
=CORREL(array1, array2)- array1 — первая серия чисел (например, столбец с годами).
- array2 — вторая серия чисел (например, столбец с ценами).
Примечание: в англоязычной версии Excel функция называется CORREL; в локализованных версиях имя функции может быть переведено. Если вы используете русскую локаль Excel и не уверены, введите формулу в строке формул и воспользуйтесь автозаполнением.
Пример: у вас есть таблица с моделями автомобилей, годами выпуска и текущей ценой. Вы хотите понять, связаны ли год и цена. Введите формулу вида =CORREL(B2:B101, C2:C101), где B — год, C — цена, и получите числовой коэффициент.
В этом примере видна слабая положительная корреляция: год выпуска слабо положительно связан с ценой автомобиля.
Графическое отображение корреляций
Для понимания взаимосвязей всегда полезно смотреть на график. Лучше всего подходят диаграммы рассеяния.
Шаги для создания диаграммы рассеяния:
- Выделите две колонки данных (X и Y).
- В Excel выберите Вставка > Диаграммы > Точечная (Scatter).
- При необходимости подпишите оси и форматируйте маркеры.
Чтобы сделать зависимость более очевидной, добавьте трендлайн (линейную аппроксимацию):
- В Windows: выберите диаграмму → Конструктор диаграмм → Добавить элемент диаграммы → Линия тренда.
- В macOS: выберите диаграмму и используйте макеты диаграммы в вкладке Конструктор диаграмм или Макет диаграммы.
На диаграмме видно, насколько точки близки к тренду. Чем ближе точки к линии, тем выше абсолютное значение r.
Корреляция нескольких переменных: Надстройка «Анализ данных»
Если у вас много колонок и нужно получить матрицу попарных корреляций, вручную считать CORREL для каждой пары неудобно. Надстройка «Анализ данных» (Analysis ToolPak) автоматизирует задачу.
Как включить надстройку, если она не активна:
- Файл > Параметры > Надстройки.
- Внизу окна выберите Управление: Excel Add-ins и нажмите Перейти.
- Поставьте галочку у Analysis ToolPak и нажмите ОК.
Дальше: Данные > Анализ данных > Корреляция.
В окне «Корреляция» укажите входной диапазон (несколько столбцов) и место вывода. Excel создаст матрицу корреляции, где каждая ячейка показывает r между соответствующими переменными.
Пример результата (матрица корреляции) — на выходе вы получаете квадратную таблицу с 1 на диагонали (каждая переменная полностью коррелирует сама с собой) и попарными r в остальных клетках:
На примере в изображении матрица показывает сильную положительную связь между годом и мировой популяцией и слабые связи с рандомизированными наборами.
Корреляция и линейная регрессия — в чём разница?
Корреляция измеряет силу и направление линейной связи между двумя переменными, но не позволяет утверждать о причинности. Линейная регрессия даёт модель, с помощью которой можно прогнозировать Y по X, и предоставляет статистические тесты значимости (например, p-value).
Небольшая инструкция по запуску регрессии в Excel (через «Анализ данных»):
- Данные > Анализ данных > Регрессия.
- Укажите X Range (объясняющая переменная) и Y Range (зависимая переменная).
- Укажите место вывода и нажмите ОК.
В отчёте регрессии обратите внимание на:
- Коэффициенты регрессии (Intercept и Beta для X).
- P-value для каждого коэффициента — если p < 0.05, обычно считают эффект статистически значимым (при уровне значимости 5%).
- R-квадрат — доля дисперсии Y, объяснённая моделью.
Регрессия также позволяет включать несколько объясняющих переменных одновременно (множественная регрессия). Но если объясняющие переменные сильно коррелированы между собой (мультиколлинеарность), выводы могут быть искажены.
Практические советы и распространённые ошибки
Important: перед расчётом корреляции проверьте данные.
- Убедитесь, что переменные числовые и сопоставимы по размерности (избегайте смешения процентов и абсолютных значений без нормализации).
- Ищите выбросы — одиночные экстремальные точки могут сильно изменить r.
- Проверьте на однородность распределения и линейность. Для нелинейных зависимостей используйте Спирмена или моделирование.
- Не полагайтесь только на p-value: большие выборки могут делать малозначимые эффекты статистически значимыми.
- Помните о «ложной корреляции» — два показателя могут «коррелировать» из-за третьей, скрытой переменной.
Когда корреляция вводит в заблуждение (несколько примеров):
- Сезонные или трендовые данные: если обе серии растут со временем, между ними будет высокая корреляция, хотя прямой причинно-следственной связи нет. В таких случаях удаляйте тренд или используйте разности.
- Нелинейные зависимости: сильная квадратичная связь может давать низкое r.
- Малые выборки: r в маленьких выборках нестабилен.
Альтернативные и дополнительные методы
- Ранговая корреляция Спирмена — полезна для монотонных, но не обязательно линейных связей.
- Корреляция Кендалла — устойчива к выбросам в ранговых данных.
- Частная корреляция — показывает связь между двумя переменными при контроле третьей.
- Нелинейное моделирование (полиномы, SVM, деревья) — когда связь явно не линейна.
Мини‑методология: от данных до интерпретации (короткий SOP)
- Предварительная проверка: типы данных, пропуски, дубликаты.
- Визуализация: гистограммы + диаграмма рассеяния.
- Оценка линейности: добавьте линейный трендлайн, посмотрите на распределение остатков.
- Вычисление: CORREL для пары, матрица корреляций для множества колонок.
- Проверка значимости: при необходимости используйте регрессию и p-value.
- Контроль факторов: проверьте влияние возможных совместно изменяющихся переменных.
- Документирование: сохраняйте скриншоты, версии данных и шаги анализа.
Роль‑ориентированные чек‑листы
Аналитик:
- Проверить и очистить данные.
- Построить scatter plot и добавить трендлайн.
- Рассчитать CORREL и сравнить с матрицей корреляций для всех переменных.
- Если нужно — построить регрессию и проверить p-value.
Руководитель продуктовой команды:
- Попросить отчёт с визуализацией и краткими выводами о практической значимости эффекта.
- Проверить, контролировались ли ключевые факторы и тренды.
Data Engineer:
- Обеспечить версию исходных данных, метаданные и reproducibility.
- Настроить автоматическую проверку на пропуски, выбросы и изменение схемы данных.
Критерии приёмки (чего достаточно, чтобы считать анализ завершённым)
- Проведена очистка данных и устранены или документированы пропуски/выбросы.
- Есть диаграмма рассеяния для каждой ключевой пары переменных.
- Рассчитан CORREL, и при необходимости — матрица корреляций.
- Для утверждений о причинности проведён регрессионный анализ с проверкой p-value и обсуждением возможных внешних факторов.
- Примечания о возможных ограничениях включены в финальный отчёт.
Тесты и критерии приемки для проверки корректности расчётов
- Тест 1: Для двух идентичных массивов чисел CORREL должен равняться 1.
- Тест 2: Для массива и его отрицания (X и −X) CORREL должен равняться −1.
- Тест 3: Для двух независимых наборов случайных чисел r должен быть близок к 0 (в больших выборках).
- Тест 4: При удалении одного сильного выброса значение r должно заметно измениться — если так, вынесите выброс в отдельный анализ.
Быстрый справочник (cheat sheet)
- Формула: =CORREL(диапазон1, диапазон2)
- Включение надстройки: Файл > Параметры > Надстройки > Analysis ToolPak
- Построение scatter plot: Вставка > Диаграммы > Точечная
- Добавление трендлайна: Выделить диаграмму → Конструктор диаграмм → Добавить элемент диаграммы → Линия тренда
Ментальные модели и эвристики
- “Близко к линии” = сильная линейная связь. Визуальная оценка обычно помогает быстрее понять структуру данных, чем одномерный r.
- “Тренд-ловушка”: если обе серии растут с течением времени, корреляция может быть высокой, но это простой эффект времени, а не реальная взаимосвязь.
- “Контроль третьей переменной”: представьте, что оба показателя зависят от погоды/времени/цен на сырьё — тогда прямая связь может оказаться вторичной.
Короткий глоссарий
- Коэффициент корреляции: число от −1 до 1, измеряющее линейную связь.
- Трендлайн: аппроксимационная прямая на диаграмме рассеяния.
- P-value: вероятность получить наблюдаемый эффект при нулевой гипотезе; часто порог 0.05.
Часто задаваемые вопросы
Какой порог считать “сильной” корреляцией?
Нету жёсткого правила — обычно |r| > 0.7 считают сильной, 0.4–0.7 средней, <0.4 слабой, но контекст важен.
Можно ли использовать CORREL для пустых ячеек?
CORREL игнорирует текстовые значения, но пустые ячейки могут нарушить выравнивание диапазонов. Убедитесь, что диапазоны одинаковой длины и очищены от непредвиденных текстовых значений.
Что делать, если данные не линейны?
Попробуйте ранговую корреляцию Спирмена или постройте нелинейную модель (полином, регрессия с трансформациями, деревья).
Заключение
Коэффициент корреляции — простой и мощный инструмент для первичной оценки линейной связи между переменными. Excel предоставляет быстрые способы расчёта: функция CORREL для пар и Надстройка «Анализ данных» для матриц корреляций. Не забывайте визуализировать данные, проверять предпосылки и учитывать, что корреляция не означает причинности.
Summary:
- Проверьте и подготовьте данные.
- Визуализируйте связь через диаграмму рассеяния.
- Рассчитайте CORREL или матрицу корреляций.
- Для утверждений о причинности используйте регрессию и статистические тесты.
Спасибо за внимание. Используете ли вы CORREL в своей работе? Какие статистические приёмы вы хотели бы изучить дальше?

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
