
iconv: как безопасно конвертировать кодировки текста в Linux
TL;DR
iconv — это утилита командной строки для перекодировки текстовых файлов между кодировками (UTF-8, UTF-16, ASCII и мн.др.). Она умеет пропускать неподдерживаемые символы, выполнять транслитерацию и работать со стандартными потоками. Используйте iconv, когда нужно быстро привести файлы к единой кодировке перед обработкой или загрузкой.
Важно: всегда сохраняйте резервную копию исходного файла перед массовой перекодировкой.
Быстрая карта (primary intent и варианты)
- Основная задача: конвертация кодировок файлов
- Варианты запросов: iconv, перекодировка UTF-8 в ASCII, определение кодировки файла, транслитерация символов, проблемы с BOM
Почему это важно
Компьютеры хранят любые данные в виде двоичных значений. Чтобы правильно отобразить текст на экране, программа должна знать, какая таблица соответствия (кодировка) использовалась при создании данных. Ошибки в интерпретации кодировки приводят к «кракозябрам», потерям символов и проблемам при импорте данных в базы или при отображении веб‑страниц.
Это всё двоично
Независимо от типа данных — изображение, музыка или текст — на диске или в памяти они представлены в виде последовательностей байтов. Для текста требуется дополнительный шаг: перевод этих байтов в символы. Перевод выполняется по заранее заданной карте кодовых точек (character mapping).
Примечание: кодовая точка — это целое число, которое однозначно идентифицирует символ в конкретной кодировке.
Символы, байты и соответствия
- Символ (character) — отображаемый знак: буква, цифра, пунктуация, валютный символ и т. д.
- Глиф — визуальное представление символа на экране.
- Набор символов (character set) — совокупность символов с уникальными кодовыми точками.
- Количество байтов на символ влияет на максимальный размер набора.
ASCII — классика: 7‑битное пространство на 128 кодовых точек. Unicode намного шире: пространство до 1 114 112 кодовых точек, чтобы покрыть письменности мира. Фиксированное число байтов на символ бывает неэффективно: поэтому используются переменные кодировки (UTF‑8, UTF‑16), где одиночный символ может занимать от 1 до 4 байт.
Преимущества переменной длины: экономия места для латиницы. Недостаток: сложность парсинга и перекодировки.
Именно для решения сложных случаев и предназначен iconv.
Как пользоваться командой iconv
iconv поддерживает множество кодировок (сотни, включая алиасы). Список поддерживаемых кодировок выводится опцией -l:
iconv -l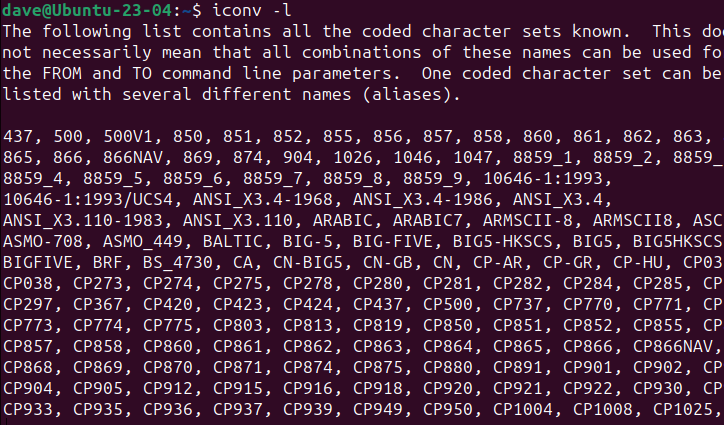
Обязательные параметры при перекодировке: исходная кодировка (-f), целевая кодировка (-t). По умолчанию iconv читает STDIN и пишет STDOUT, если не указаны файлы.
Пример на STDIN и транслитерация
Сначала определим локаль, чтобы узнать текущую кодировку:
locale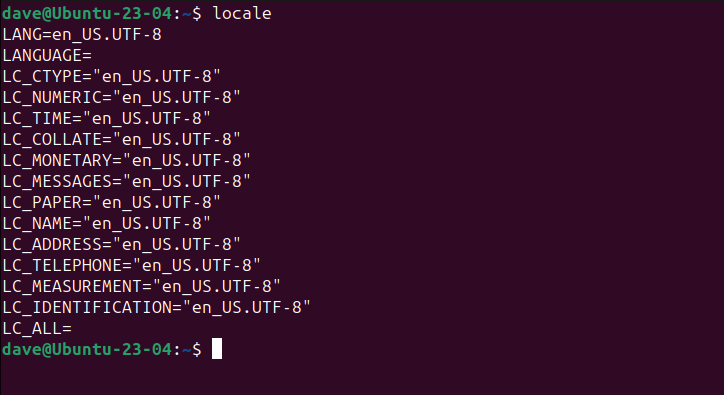
Тестовая строка содержит обычные и специальные символы:
plain àccented non-English ß Foreign currency €Пытаемся перекодировать в ASCII:
echo plain àccented non-English ß Foreign currency € | iconv -f UTF-8 -t US-ASCIIЕсли в целевой кодировке нет соответствия для какого‑то символа (например «à» в US‑ASCII), iconv завершит работу с ошибкой, указав позицию в нулевой базе.
Чтобы пропустить неподдерживаемые символы и продолжить, используйте опцию -c (continue):
echo plain àccented non-English ß Foreign currency € | iconv -f UTF-8 -t US-ASCII -cЕсли хотите получить похожее замещение (транслитерацию), добавьте к целевой кодировке суффикс //TRANSLIT:
echo plain àccented non-English ß Foreign currency € | iconv -f UTF-8 -t US-ASCII//TRANSLITРезультат: «à» → «a», «ß» → «ss», «€” → «EUR».
Работа с файлами
Чтобы узнать кодировку файла, используйте команду file:
file -i input.txtИллюстрация: входной файл в кодировке UTF-16LE. Это little‑endian 16‑бит кодировка.
less input.txt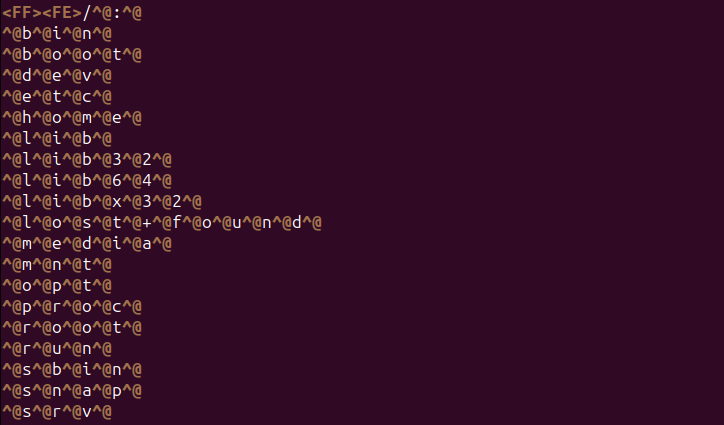
Для конвертации в UTF‑8 используйте:
iconv -f UTF-16LE -t UTF-8//TRANSLIT input.txt -o output.txtПроверяем результат:
less output.txt
Частые сценарии и советы
- Всегда делайте резервную копию файлов перед массовой перекодировкой.
- Если иконки или символы «ломаются», проверьте BOM (Byte Order Mark) и используйте корректную кодировку (UTF‑16LE vs UTF‑16BE).
- Для пакетной обработки используйте цикл shell или find + xargs.
- При сомнении о кодировке сначала примените инструменты определения (file, uchardet), затем iconv.
Пример пакетной обработки
find . -name '*.txt' -print0 | xargs -0 -I{} sh -c 'iconv -f WINDOWS-1252 -t UTF-8//TRANSLIT "{}" -o "{}".utf8 && mv "{}".utf8 "{}"'Этот пример пытается перекодировать файлы из WINDOWS-1252 в UTF-8 с транслитерацией и перезаписывает исходные файлы только при успешной конвертации.
Когда iconv может не подойти (контрпримеры)
- Файл повреждён (битые последовательности) — iconv может завершиться с ошибкой; предварительно проверьте файл с помощью hexdump/xxd.
- Файл содержит смешанные кодировки — iconv ожидает одну кодировку для входа. Для таких случаев сначала нормализуйте данные (скрипт, ручная проверка) или применяйте пост‑обработку.
- Требуется точная обратимая трансформация (без потери информации) между несовместимыми наборами: некоторые символы просто не имеют эквивалента.
Альтернативные подходы
- recode — древняя утилита, подходит для ряда кодировок и исторических случаев.
- enca / uchardet — помогают угадать кодировку файла прежде, чем вызывать iconv.
- Python (chardet + codecs) — гибко для сложных сценариев, когда нужен скрипт с логикой.
- текстовые редакторы с поддержкой определённых кодировок (VS Code, Sublime) — удобны для ручной правки.
Ментальные модели и эвристики
- «Куда идти?» — сначала определите входную кодировку, затем целевую.
- «Безопасность прежде всего» — если есть сомнения, сделайте копию и работайте с копией.
- «Транслитерация ≠ восстановление» — транслитерация пытается представить символ похожим образом, но это не всегда семантически корректная замена.
Быстрый чек‑лист по ролям
- Системный администратор:
- Найти файлы с подозрительными кодировками (find + file).
- Пакетная перекодировка с логированием и бэкапом.
- Мониторинг ошибок после импорта данных.
- Разработчик:
- Настроить CI, чтобы тесты проверяли корректную кодировку входных файлов.
- Использовать UTF-8 как стандарт внутри сервиса.
- Локализатор / переводчик:
- Проверить, не теряются ли специфичные локальные символы при транслитерации.
- Убедиться, что файлы от сотрудников Windows/Mac обрабатываются корректно.
Шпаргалка команд (cheat sheet)
- Список кодировок:
iconv -l- Конвертация STDIN → STDOUT:
echo текст | iconv -f UTF-8 -t WINDOWS-1251- Пропуск неподдерживаемых символов:
iconv -f UTF-8 -t US-ASCII -c- Транслитерация:
iconv -f UTF-8 -t US-ASCII//TRANSLIT- Файл → Файл:
iconv -f UTF-16LE -t UTF-8//TRANSLIT input.txt -o output.txt- Пакетная транскодировка с проверкой:
for f in *.txt; do iconv -f ISO-8859-1 -t UTF-8//TRANSLIT "$f" -o "$f.utf8" && mv "$f.utf8" "$f"; donePlaybook: безопасная перекодировка файла
- Создать резервную копию: cp input.txt input.txt.bak
- Определить кодировку: file -i input.txt || uchardet input.txt
- Выполнить тестовую конвертацию на часть файла: head -n 50 input.txt | iconv -f
-t //TRANSLIT - Если вывод корректен, сделать полную перекодировку в новый файл: iconv -f
-t //TRANSLIT input.txt -o output.txt - Сравнить: diff -u <(iconv -f
-t UTF-8 input.txt | head) <(cat output.txt | head) - Перезаписать исходный файл после проверки или сохранить как новый.
Критерии приёмки
- Файл открывается в целевых приложениях и не содержит «кракозябр» в ключевых строках.
- Проверены первые и последние 100 строк на предмет целостности и ожидаемых символов.
- Лог конвертации фиксирует ошибки и количество пропущенных символов.
Тесты и сценарии приёмки
- Тест 1: простой латинизированный текст — ожидается полная конвертация без пропусков.
- Тест 2: символы с диакритикой при конвертации в ASCII — ожидается использование //TRANSLIT или явные пропуски.
- Тест 3: смешанные кодировки внутри файла — ожидается выявление проблемы и отказ при строгой проверке.
Короткая методика отладки
- Если iconv падает с ошибкой позиции — посмотрите byte offset через hexdump, чтобы выделить проблемное место.
- Для поиска возможных кодировок используйте uchardet или enca и попробуйте несколько вариантов.
- Если файл в UTF-16 и выглядит как «бинарный», возможно отсутствует BOM; попробуйте -f UTF-16LE или UTF-16BE в зависимости от порядка байтов.
1‑строчный глоссарий
- BOM — специальная последовательность байтов в начале файла, указывающая порядок байтов и кодировку.
- Транслитерация — замена символа на похожий по форме или звучанию в целевой кодировке.
- Кодовая точка — числовой идентификатор символа в таблице кодировки.
Риски и смягчающие меры
- Риск: потеря символов при конвертации в более узкую кодировку.
- Мера: использовать //TRANSLIT и проверять результаты вручную.
- Риск: неверно определённая исходная кодировка.
- Мера: применить несколько инструментов определения (file, uchardet, enca) и выполнить тестовую конвертацию.
Когда iconv спасёт ситуацию
Если вы получаете файлы из разных систем (Windows, Mac, старые unix), iconv часто позволяет быстро привести их к единой кодировке — это упрощает дальнейшую обработку, импорт в БД и отображение на сайте.
Краткое резюме
iconv — простой и мощный инструмент для перекодировки текстов. Он поддерживает транслитерацию, работу со стандартными потоками и пакетную обработку через shell. Всегда сохраняйте резервные копии, проверяйте исходную кодировку и тестируйте на фрагментах перед масс‑конвертацией.
Important: Убедитесь, что ваша целевая система поддерживает выбранную кодировку и что после конвертации данные читаются и обрабатываются корректно.
Короткая памятка для социальных сетей: iconv: быстрое руководство по перекодировке файлов и транслитерации символов — как избежать потери данных при работе с разными кодировками.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
