
AWS Textract — обзор и руководство по использованию
Важно: цены в статье указаны в долларах США, как в официальной документации AWS.
Быстрые ссылки
- Почему использовать AWS Textract
- Как использовать Textract (консоль и CLI)
- Автоматизация и проверки качества
- Альтернативы и ограничения
Почему стоит использовать AWS Textract?
Много компаний до сих пор использует людей для ручного ввода данных с бумажных форм и заявлений. Такой подход точен, но медлен и дорог. AWS Textract применяет машинное обучение, чтобы автоматизировать извлечение текста и структурированных сущностей — ключ-значение, таблиц и других важных полей.
Textract — не простой OCR (оптическое распознавание символов). В отличие от базовых движков, он заточен на анализ структурированных документов: может обнаруживать поля формы, связывать ключи и значения и выделять табличные структуры. Это делает его удобным слоем между отсканированными документами и базой данных — при условии, что вы настроите дальнейший парсинг и валидацию.
Ещё одно преимущество — это полностью управляемая облачная служба: не нужно развёртывать собственные серверы OCR и тюнинговать модели. Загрузили документ в консоль или отправили через API — получили результат.
Если у вас пока ручной ввод, Textract может экономить деньги и время: массовая обработка заметно быстрее, а стоимость за тысячу страниц часто ниже, чем оплата людей. Пример цен из официальной документации (в USD):
- Прямой текст: $1.50 за 1000 страниц
- Анализ таблиц: $15.00 за 1000 страниц
- Ключ-значение (формы): $50.00 за 1000 страниц
Textract достаточно точен в типичных сценариях, но для низкого уровня доверия AWS предлагает интеграцию с Amazon Augmented AI (A2I): низкоуверенные результаты автоматически направляются на проверку человеку.
Использование Textract через консоль
Перейдите в Textract Management Console и нажмите “Get started”. В консоли можно вручную загрузить документ кнопкой загрузки:
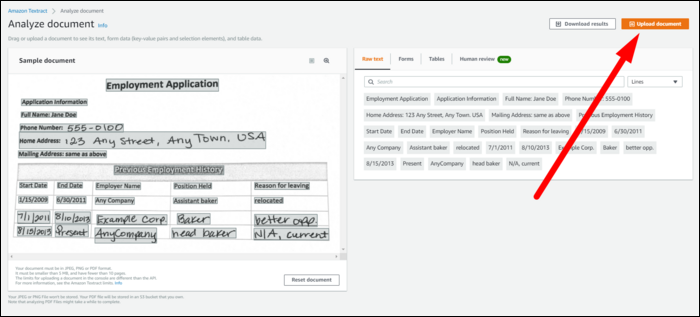
После обработки вы увидите, какие фрагменты текста сервис посчитал важными: какие поля распознаны как пары ключ-значение, какие — как таблицы, а что можно игнорировать.
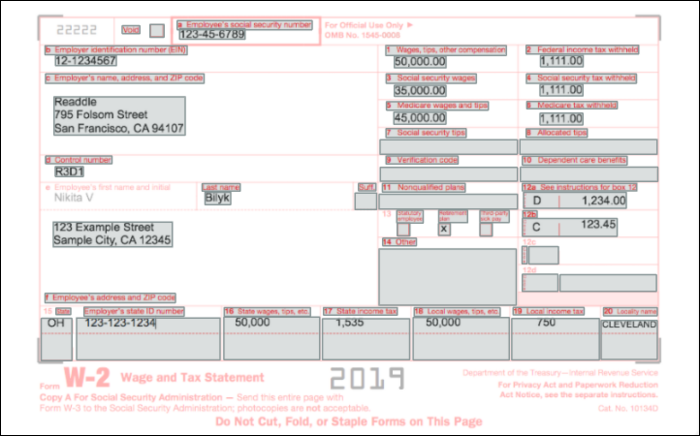
На правой панели отображается вывод — сырые строки, пары ключ-значение и таблицы. Поля могут пересекаться: одно и то же значение иногда попадает и в таблицу, и в пару ключ-значение.

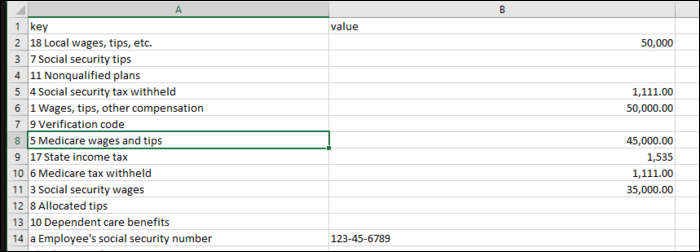
Результаты можно скачать: CSV с таблицами и парами ключ-значение, а также текстовый файл со всем распознанным текстом.
Использование Textract через CLI и API
Для автоматизации используйте AWS CLI или SDK. Документ можно передать двумя способами: сериализовать в base64 и отправить байты, либо загрузить файл в S3 и указать ключ объекта.
Синхронный анализ через CLI (пример):
analyze-documentПример команды, запускающей анализ документов и распознавание таблиц и форм:
aws textract analyze-document --document '{"S3Object":{"Bucket":"bucket","Name":"document"}}' --feature-types '["TABLES","FORMS"]'Это синхронная операция. Для асинхронного анализа запускают задание и затем получают результаты вручную:
aws textract get-document-analysis --job-id df7cf32ebbd2a5de113535fcf4d921926a701b09b4e7d089f3aebadb41e0712b --max-results 1000Асинхронный подход удобен для больших объёмов: вы получаете JobId, а затем периодически опрашиваете состояние и скачиваете результаты.
Мини-методология интеграции Textract в рабочий процесс
- Определите типы документов и поля, которые нужны бизнесу (счета, договоры, анкеты).
- Соберите репрезентативную выборку сканов с разной качественностью и форматами.
- Запустите Textract на тестовой выборке, экспортируйте CSV/JSON результатов.
- Настройте сопоставление полей (mapping) из Textract → структура вашей БД.
- Внедрите шаги валидации: правила, регулярные выражения, контрольные суммы.
- Настройте Amazon A2I для ручной проверки низкоуверенных результатов.
- Постепенно расширяйте охват документов и отслеживайте метрики качества.
Рольовые чеклисты при внедрении
Разделены по ролям для ясности.
Инженер данных:
- Настроить S3-баффер для входящих изображений.
- Скрипты по отправке файлов в Textract и сбору результатов.
- Мониторинг ошибок парсинга и отказов API.
DevOps/Cloud:
- Политики IAM: минимальные права для Textract и S3.
- Настроить KMS, если храните чувствительные документы.
- Автоматизация масштабирования и оповещений при сбоях.
Бизнес-аналитик/Product:
- Составить список обязательных и опциональных полей.
- Настроить правила валидации и KPI качества извлечения.
- План поручной выборочной валидации при запуске.
Критерии приёмки
- Процент заполнения обязательных полей ≥ требуемого порога (установьте своё значение).
- Ошибки критичных полей (например, ИНН, суммы) вручную исправляются не чаще чем в N% случаев.
- Система автоматически направляет на ручную проверку все записи ниже порога доверия.
Примечание: конкретные пороги устанавливаются вашей командой в зависимости от допустимого уровня риска.
Когда Textract не подойдёт (ограничения и примеры отказа)
- Плохо отсканированные документы: сильные искажения, размытость и тёмные снимки снижают точность.
- Неоднородные или рукописные формы: рукописный текст распознаётся хуже, особенно если почерк неразборчив.
- Документы с очень специфической структурой или отраслевыми сокращениями — потребуются дополнительные правила постобработки.
Контрпример: для книг и печатных текстов классический OCR (Tesseract) может быть дешевле и проще при отсутствии структурных требований.
Альтернативы и сравнение (кратко)
- Tesseract OCR — бесплатный движок с открытым исходным кодом; хорош для простого OCR, сложнее извлекать структуры.
- Google Cloud Vision / Document AI — управляемые альтернативы с похожими возможностями извлечения сущностей.
- Azure Form Recognizer — конкурентный сервис от Microsoft, ориентирован на формы и таблицы.
Выбор зависит от требований к качеству, защищённости данных, стоимости и локализации инфраструктуры.
Безопасность и приватность
- Храните конфиденциальные документы в S3 с ограниченным доступом и шифрованием (KMS).
- Применяйте принцип наименьших привилегий для IAM-пользователей, ботов и ролей.
- При работе с персональными данными проверьте соответствие локальным требованиям по обработке (например, GDPR/локальные законы). Textract сам по себе — инструмент; ответственность за соответствие лежит на владельце данных.
Примеры тест-кейсов и приёмки
- Тест 1: Загружать 100 документов одной формы, проверять корректность распознавания обязательных полей.
- Тест 2: Проверить реакцию на документ со сложными таблицами: строки, объединённые ячейки, вложенные таблицы.
- Тест 3: Эмуляция низкого качества сканов: проверить, какие документы идут на A2I.
Шаблон быстрой проверки (чек-лист)
- Документ успешно загружен в S3
- Textract вернул JSON без ошибок
- Все обязательные поля распознаны
- Низкоуверенные поля отмечены и отправлены на A2I
- Результаты записаны в базу и доступны для отчётности
Часто задаваемые вопросы
Как настроить автоматическую валидацию низкоуверенных результатов?
Используйте Amazon A2I: настраиваете рабочий поток, указываете порог уверенности и список проверяющих. Низкоуверенные элементы будут помещаться в задачу для человека.
Можно ли анализировать документы полностью локально, без облака?
Textract — облачный сервис; если нужен полностью локальный сценарий, рассмотрите локальные OCR-движки (Tesseract) и собственные ML-модели, но это потребует больше ресурсов и поддержки.
Какие форматы входных файлов поддерживаются?
Textract поддерживает распространённые форматы изображений и PDF. Подробный список лучше сверять в официальной документации AWS.
1-line glossary
- OCR — оптическое распознавание символов, извлечение текста из изображений.
- A2I — Amazon Augmented AI, сервис для маршрутизации низкоуверенных результатов на ручную проверку.
- S3 — объектное хранилище AWS для загрузки исходных документов.
Краткое резюме:
- Textract ускоряет ввод данных и умеет извлекать структуры из документов.
- Используйте консоль для тестов, CLI/SDK для автоматизации, A2I для ручной проверки.
- Планируйте этапы валидации, настройте IAM/KMS и тщательно тестируйте на репрезентативной выборке.
Важно: для критичных бизнес-процессов всегда оставляйте этапы ручной проверки и метрики качества.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
