
Резервные копии Elasticsearch: снимки (Snapshot) на NFS и восстановление
Elasticsearch использует механизм Snapshot для создания резервных копий работающего кластера. Снимок можно сделать для отдельного индекса или для всего кластера — при этом кластер не нужно останавливать, что исключает простои приложений. Снимки являются инкрементными: при создании нового снимка Elasticsearch не копирует данные, уже сохранённые в предыдущих снимках того же индекса, что экономит место и время.
Кроме создания снимков, Elasticsearch позволяет восстанавливать их в работающий кластер. При восстановлении можно переименовать индекс и изменить отдельные настройки.
Для выполнения операций snapshot/restore необходимо зарегистрировать репозиторий для снимков. В случае файлового (fs) репозитория это требует, чтобы на всех master и data‑узлах был примонтирован общий каталог в одном и том же пути и чтобы этот путь был указан в настройке path.repo в elasticsearch.yml на всех узлах.
Кому полезно
- Операторам и инженерам DevOps, которые администрируют кластеры Elasticsearch.
- Командам, отвечающим за отказоустойчивость и бэкапы.
Предварительные требования
- Общая NFS‑папка доступна и смонтирована на всех трёх узлах Elasticsearch в одном и том же пути.
- Рабочий Elasticsearch‑кластер из трёх узлов на Ubuntu (master/data на каждом узле в примере).
- Доступ по HTTP(S) к одному из узлов для выполнения curl‑команд.
Что мы сделаем
- Проверим NFS и права на директории.
- Проверим и настроим конфигурацию Elasticsearch (path.repo).
- Зарегистрируем репозиторий для снимков.
- Создадим снимок и восстановим его, проверим результат.
Проверка NFS (кратко)
Подробная настройка NFS выходит за рамки этой статьи. Важно убедиться в двух вещах:
- Общая директория NFS, например /home/ubuntu/shared, экспортируется сервером и монтируется у клиентов в одном и том же пути, например /home/ubuntu/mounted.
- Владелец и права папки совпадают с тем пользователем, под которым запускается Elasticsearch (обычно elasticsearch).
Пример инфраструктуры в статье (IP‑адреса для примера):
es-node-1(10.11.10.61)  : NFS Client
es-node-2(10.11.10.62) : NFS Client
es-node-3(10.11.10.63) : NFS Client
NFS Server(10.11.10.64) : NFS Server
NFS сервер шарит каталог “/home/ubuntu/shared/“. На каждом узле Elasticsearch этот каталог примонтирован в “/home/ubuntu/mounted”. Убедитесь, что права доступа и владелец корректны.
Проверка конфигурации кластера Elasticsearch
Единственная дополнительная настройка, необходимая для резервного копирования в файловый репозиторий, — это объявление пути для репозиториев в elasticsearch.yml:
path.repo: ["/home/ubuntu/mounted"]Добавьте эту строку в elasticsearch.yml на каждом узле и перезапустите узел после изменений.
Пример минимальной конфигурации для трёх узлов (elasticsearch.yml):
Node 1
cluster.name: my-cluster
node.name: "es-node-1"
node.master: true
node.data: true
network.host: 10.11.10.61
http.port: 9200
discovery.zen.ping.unicast.hosts: ["10.11.10.61", "10.11.10.62", "10.11.10.63"]
cluster.initial_master_nodes:
- 10.11.10.61
path.repo: ["/home/ubuntu/mounted"]
Node 2
cluster.name: my-cluster
node.name: "es-node-2"
node.master: false
node.data: true
network.host: 10.11.10.62
http.port: 9200
discovery.zen.ping.unicast.hosts: ["10.11.10.61", "10.11.10.62", "10.11.10.63"]
path.repo: ["/home/ubuntu/mounted"]
Node 3
cluster.name: my-cluster
node.name: "es-node-3"
node.master: false
node.data: true
network.host: 10.11.10.63
http.port: 9200
discovery.zen.ping.unicast.hosts: ["10.11.10.61", "10.11.10.62", "10.11.10.63"]
path.repo: ["/home/ubuntu/mounted"]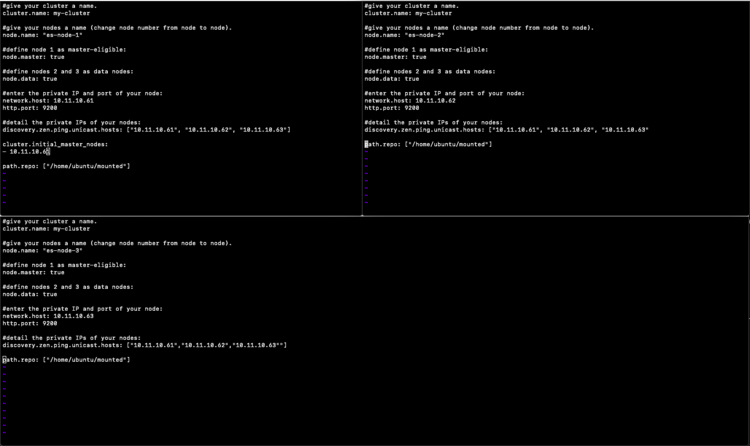
Запускайте узлы в правильном порядке: сначала initial master, затем остальные.
Регистрация репозитория для снимков
Проверим, есть ли уже зарегистрированные репозитории:
curl -XGET 'http://IP_Of_Elasticsearch_Node_Or_Master:9200/_snapshot/_all?pretty=true'Если ответ пустой — репозиториев нет.
Создадим файловый репозиторий my_backup, указывая путь к примонтированной NFS‑папке:
curl -XPUT 'http://IP_Of_Elasticsearch_Node_Or_Master:9200/_snapshot/my_backup' -H 'Content-Type: application/json' -d '{
  "type": "fs",
  "settings": {
    "location": "/home/ubuntu/mounted",
    "compress": true
  }
}'
Проверьте регистрацию:
curl -XGET 'http://IP_Of_Elasticsearch_Node_Or_Master:9200/_snapshot/_all?pretty=true'Важно: значение location должно быть доступно и записываемо с каждого узла по указанному пути.
Создание снимка (Backup)
После регистрации репозитория можно создать снимок. Простейшая команда для полного снимка:
curl -XPUT 'http://IP_Of_Elasticsearch_Node_Or_Master:9200/_snapshot/my_backup/snapshot_name?wait_for_completion=true'Опции, которые часто используются:
- wait_for_completion=true — дождаться завершения операции до возврата ответа.
- indices=index1,index2 — создать снимок только указанных индексов.
- include_global_state=true/false — включать ли глобальные настройки кластера.
Пример создания снимка только двух индексов без глобального состояния:
curl -XPUT 'http://IP_Of_Elasticsearch_Node_Or_Master:9200/_snapshot/my_backup/snapshot_name?wait_for_completion=true' -H 'Content-Type: application/json' -d '{
  "indices": "index1,index2",
  "include_global_state": false
}'
Восстановление снимка (Restore)
Восстановление снимка можно выполнить в работающий кластер. Простая команда для восстановления всего снимка:
curl -XPOST 'http://IP_Of_Elasticsearch_Node_Or_Master:9200/_snapshot/my_backup/snapshot_name/_restore?wait_for_completion=true'Полезные параметры при восстановлении:
- indices — список индексов для восстановления.
- rename_pattern и rename_replacement — переименование индексов при восстановлении.
- include_global_state — восстанавливать ли настройки кластера.
- ignore_unavailable — игнорировать отсутствующие индексы в снимке.
Пример восстановления с переименованием индекса:
curl -XPOST 'http://IP_Of_Elasticsearch_Node_Or_Master:9200/_snapshot/my_backup/snapshot_name/_restore?wait_for_completion=true' -H 'Content-Type: application/json' -d '{
  "indices": "index1",
  "rename_pattern": "index(.+)",
  "rename_replacement": "restored_index$1"
}'
Проверка результата
- Убедитесь, что восстановленные индексы появились: curl GET /_cat/indices?v
- Проверьте состояние кластера: curl GET /_cluster/health?pretty
- Просмотрите содержимое репозитория: curl GET /_snapshot/my_backup/_all?pretty
Частые проблемы и отладка
Important: проверьте права записи на NFS и согласованность UID пользователя elasticsearch на всех узлах. Если владелец отличается, Elasticsearch может не получить доступ к репозиторию.
Типичные ошибки и решения:
Ошибка: repository_not_found_exception — репозиторий не зарегистрирован или location неверен. Решение: убедитесь, что path.repo в elasticsearch.yml включает путь и что этот путь примонтирован идентично на всех узлах.
Ошибка: failed_to_create_snapshot или IO ошибки — проблемы с правами или с сетью/файловой системой. Решение: проверьте права, смонтирован ли NFS с опцией rw, проверьте логи Elasticsearch на всех узлах.
Снимки зависают или очень долго снимаются — возможно большое количество сегментов/маленьких файлов. Решение: рассмотрите использование репозиториев в объектных хранилищах (S3, Azure) или увеличение снэпшот‑интеграции за счёт индексации и merge.
Когда snapshot‑подход не подходит (контрпримеры)
- Очень большие индексы с миллионами мелких файлов на NFS могут приводить к медленным операциям и проблемам с производительностью.
- Если требуется непрерывная точность до миллисекунд (RPO ~= 0) — snapshot‑процесс не заменит репликацию и логирование изменений.
- Если нет возможности обеспечить одинаковые пути на всех узлах, файловый репозиторий не подходит; нужен облачный репозиторий или плагин.
Альтернативные подходы
- Репозитории S3/Google Cloud Storage/Azure Blob Storage через соответствующие плагины — рекомендуется для облачных и распределённых окружений.
- Использование инструментов уровня файловой системы (LVM snapshots, ZFS) при полном контроле над инфраструктурой — подходит для локальных решений.
- Репликация данных на уровне приложений и повторное индексирование в другом кластере как способ DR.
Мини‑методология резервного копирования (шаги)
- Проверить и зафиксировать требования RTO/RPO.
- Настроить и проверить доступ к репозиториям (права, монтирование).
- Зарегистрировать репозиторий и выполнить тестовый снимок.
- Провести тестовое восстановление в стенде и верифицировать данные.
- Настроить регулярные cron/ILM‑процедуры, мониторинг и оповещения.
- Документировать процесс и периодически тестировать восстановление.
Ролевые чеклисты
Оператор:
- Проверил монтирование NFS и права.
- Установил path.repo и перезапустил узлы.
- Зарегистрировал репозиторий и сделал тестовый снимок.
SRE/DevOps:
- Автоматизировал создание снимков (cron, Jenkins, cron‑job в Kubernetes).
- Настроил мониторинг снимков и оповещения об ошибках.
Менеджер по данным:
- Утвердил политику хранения снимков и периодичность.
- Проверил процессы восстановления на тестовом стенде.
Тестовые случаи и критерии приёмки
- Создание снимка возвращает успешный статус и запись появляется в репозитории.
- Восстановление снимка приводит к появлению индексов с ожидаемыми документами.
- Операция не приводит к деградации состояния кластера (green/yellow acceptable в зависимости от реплик).
Краткий глоссарий
- Snapshot — инкрементная резервная копия данных Elasticsearch.
- Repository — место хранения снимков (fs, s3 и т.д.).
- path.repo — настройка elasticsearch.yml, указывающая допустимые пути для файловых репозиториев.
Риски и смягчение
- Риск: повреждение NFS или потеря доступа — смягчение: хранить копии в облачном хранилище и тестировать восстановление.
- Риск: несоответствие прав/UID — смягчение: унифицировать пользователя elasticsearch на всех узлах.
- Риск: длительное время создания снимков — смягчение: увеличивать частоту инкрементов и использовать облачные репозитории.
Заключение
Снимки в Elasticsearch — гибкий и эффективный способ резервного копирования работающего кластера. Файловый репозиторий на NFS прост в настройке, но требует аккуратной работы с правами и монтированием. Для крупных производственных окружений рекомендуется рассмотреть облачные репозитории и автоматизацию: регулярные тесты восстановления — ключ к надёжной стратегии бэкапа.
Important: всегда тестируйте процессы восстановления в отдельном окружении и документируйте шаги и зависимости.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
