
Kubernetes для Docker: настройка масштабируемого кластера
Быстрые ссылки
Основы Kubernetes
Создание кластера
Определение горизонтально масштабируемого Deployment
Динамическое добавление узлов
Резюме
Введение
Docker — платформа для упаковки приложений в контейнеры, ориентированная на разработчиков. Контейнеры запускаются в любом месте, где доступно совместимое окружение выполнения. Однако Docker CLI преимущественно управляет отдельными контейнерами, что создает трудности при эксплуатации в продакшене: ручное управление множеством контейнеров быстро становится неуправляемым.
Kubernetes — это платформа оркестрации, которая управляет наборами контейнеров и масштабирует их по множеству серверов. Она упрощает развёртывание, распределение нагрузки и автоматическое восстановление. В этой статье показано, как создать кластер и масштабировать контейнеры Docker с помощью Kubernetes.
Important: если вы уже используете облачного провайдера (GCP, AWS, Azure), рассмотрите их управляемые сервисы (GKE, EKS, AKS) — они снимают часть административной нагрузки.
Основы Kubernetes
Понимание ключевых терминов поможет увидеть отличия от Docker и понять, какие компоненты отвечают за планирование и масштабирование контейнеров.
Краткие определения (одной строкой каждое):
- Master: узел управления, запускающий компоненты управляющей плоскости.
- Control Plane: сервисы на master (API-сервер, планировщик, стор конфигурации).
- Node: рабочая машина (физическая или виртуальная), где выполняются контейнеры.
- Pod: минимальная единица развертывания — группа контейнеров с общими сетевыми/томовыми характеристиками.
- ReplicaSet: обеспечивает заданное количество копий Pod.
Кластер Kubernetes — это как единое логическое вычислительное пространство, состоящее из master-узла (или нескольких для высокой доступности) и одного или нескольких worker-узлов. Master отвечает за «назначение» (scheduling) Pod на соответствующие узлы с учётом доступных ресурсов и правил.
Ключевые моменты:
- Для отказоустойчивости рекомендуется иметь как минимум одну машину, выделенную для управляющей плоскости, и два рабочих узла.
- Планировщик размещает Pod согласно запросам ресурсов и ограничениям (taints/tolerations, nodeSelector, affinity).
Создание кластера
Вы можете использовать управляемые Kubernetes-кластеры у крупных облачных провайдеров (GKE, EKS, AKS) или развернуть собственный кластер на локальных серверах/виртуальных машинах с помощью лёгких дистрибутивов (MicroK8s, k3s, kind для тестов).
Минимальные требования для простого отказоустойчивого кластера:
- 1 узел управляющий (master/control plane)
- ≥2 рабочих узла
Если вы выбираете MicroK8s на собственном хосте:
- Установите MicroK8s на каждой машине.
- На выбранном master выполните команду регистрации ноды:
microk8s add-node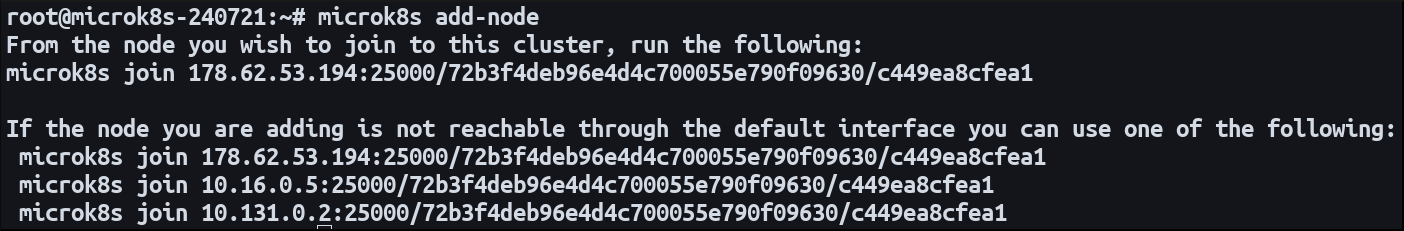
- Команда выдаст пример
microk8s join .... Выполните её на вторичном узле — он войдёт в кластер как рабочий.
После регистрации оба узла будут готовы для размещения контейнеризированных рабочих нагрузок.
Совет: для продакшен-кластера продумайте резервное копирование etcd (если используете собственную управляющую плоскость) и мониторинг состояния control plane.
Определение горизонтально масштабируемого Deployment
Горизонтальное масштабирование означает увеличение числа отдельных экземпляров (реплик) приложения и их распределение по разным средам/узлам. Вертикальное масштабирование означает увеличение ресурсов (CPU/RAM) в рамках одного узла.
Deployment — наиболее распространённый ресурс для описания рабочих нагрузок: он создаёт Pod’ы на основе образа контейнера и обеспечивает обновления, откаты и масштабирование через поле replicas.
Пример простого манифеста Deployment (YAML):
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:latest
        ports:
        - containerPort: 80
Сохраните его в файл manifest.yaml и примените к кластеру:
microk8s kubectl apply -f ./manifest.yamlKubernetes создаст три Pod’а, каждый с NGINX, и автоматически распределит их по узлам согласно доступным ресурсам.
Вы можете менять количество реплик, изменяя поле replicas и повторно применяя манифест. Снижение до 0 позволяет временно вывести приложение из эксплуатации, не удаляя Deployment и связанные ресурсы.
Ключевые проверки после применения:
- kubectl get deployments
- kubectl get pods -o wide
- kubectl describe pod
Сеть и распределение входящего трафика
При масштабировании Pod’ов важно обеспечить корректный балансировщик входящих запросов.
Типичный набор ресурсов:
- Service: абстракция для доступа к набору Pod’ов (ClusterIP, NodePort, LoadBalancer).
- Ingress: управляет внешним доступом через HTTP(S) и маршрутизацию на уровень сервисов.
Пример: создайте Service типа LoadBalancer или используйте Ingress в связке с Ingress Controller (nginx-ingress, Traefik). На облаке Service типа LoadBalancer обычно создаёт внешний балансировщик автоматически.
Замечание: при использовании bare-metal можно применять MetalLB для предоставления функциональности LoadBalancer.
Динамическое добавление узлов (автоскейлинг)
Изменение числа реплик использует существующие ресурсы кластера. Когда их не хватает, Pod’ы останутся в состоянии Pending — причина: недостаточно ресурсов для планирования.
Cluster Autoscaler — компонент, который взаимодействует с облачным провайдером, добавляя или удаляя compute-инстансы в зависимости от потребностей кластера. Для управления автоскейлингом требуется:
- Подключение к API облачного провайдера (AWS/GCP/Azure).
- Настроенные группы узлов/instance pools, которые Cluster Autoscaler может масштабировать.
Автоскейлер следит за Pod’ами в состоянии Pending и за эффективностью размещения — если Pod не может быть запланирован, он инициирует добавление узлов. Аналогично он может сокращать количество узлов, если ресурсы простаивают.
Важно: добавление узла влечёт плату у поставщика облачных услуг — учитывайте стоимость.
Когда автоскейлинг не подходит:
- Вы на локальной инфраструктуре без интеграции API гипервизора/провайдера.
- Требуется строгий контроль над каждым узлом (регламент/сертификация).
Практики безопасности и жёсткое укрепление
Базовые рекомендации:
- Используйте RBAC для управления доступом.
- Применяйте NetworkPolicies для ограничения трафика между Pod’ами.
- Минимизируйте привилегии контейнеров (runAsNonRoot, capabilities).
- Валидируйте образы контейнеров и подписывайте их (image signing).
- Включите admission controllers (например, PodSecurityPolicy или новые Pod Security Standards).
Безопасный Deployment — это не только манифест, но и процесс CI/CD, проверяющий образы и конфигурации перед релизом.
Набор ролей и обязанности (чек-листы)
Разделение обязанностей помогает избежать конфликтов и ускоряет реакции при инцидентах.
Админ кластера:
- Поддерживает control plane, апдейтит Kubernetes и etcd.
- Настраивает бэкапы и мониторинг.
- Управляет Node pools и автоскейлером.
DevOps / SRE:
- Пишет Deployment/Service/Ingress манифесты.
- Настраивает CI/CD для безопасного доставки образов.
- Следит за метриками (CPU, память, latency).
Разработчик приложения:
- Обеспечивает готовность приложения к масштабированию (stateless-first).
- Настраивает liveness/readiness probes.
- Подготавливает конфигурацию (ConfigMaps, Secrets).
Playbook: быстрая проверка при масштабировании
- Проверьте состояние кластера: kubectl get nodes
- Проверить Pods в Pending: kubectl get pods –field-selector=status.phase=Pending
- Описать Pending Pod: kubectl describe pod
- Посмотреть Event’ы на причину Pending (например, Insufficient CPU).
- Если ресурсов не хватает — увеличить
replicasтолько после того, как Node pool сможет принять дополнительные Pod’ы (или включить автоскейлер). - Проверить балансировщик и правила NetworkPolicy.
Критерии приёмки
- Deployment успешно создал N реплик.
- Все Pod’ы переходят в состояние Ready.
- Сервис/Ingress корректно направляет трафик на новые Pod’ы.
- Нет Pending Pod’ов из-за нехватки ресурсов.
Критические ошибки и что делать
Сценарий: Pod остаётся в Pending из-за Insufficient CPU. Решение: уменьшите запросы ресурсов в Pod, добавьте узлы или используйте Cluster Autoscaler.
Сценарий: Трафик не доходит до Pod. Решение: проверьте Service targetPort и selector, проверьте правила NetworkPolicy, проверьте состояние Ingress Controller.
Сценарий: частые рестарты контейнера. Решение: проверить liveness/readiness probes, логи контейнера, ограничения ресурсов и возможные утечки памяти.
Ментальные модели и эвристики
- «Stateless by default»: проектируйте приложения так, чтобы их можно было масштабировать горизонтально без зависимости от локального состояния.
- «Сначала replicas, затем nodes»: увеличьте replicas, только если кластер способен их принять, иначе сначала расширьте Node pool.
- «Readiness — доступность, Liveness — здоровье»: readiness определяет, можно ли принимать трафик; liveness — следует ли рестартовать контейнер.
Альтернативные подходы
Если Kubernetes кажется избыточным, рассмотрите:
- Docker Swarm — проще в настройке, но менее функционален для крупных кластеров.
- HashiCorp Nomad — более лёгкая и гибкая оркестрация для многих типов рабочих нагрузок.
- Serverless-платформы (Cloud Run, AWS Fargate) — избавляют от управления узлами, но не всегда подходят для всех типов приложений.
Миграция и рекомендации по версиям
- Проверяйте совместимость API между версиями Kubernetes перед апгрейдом.
- Тестируйте манифесты в staging и используйте canary/blue-green деплойменты для минимизации влияния.
- Убедитесь, что используемые CRD и ingress controllers совместимы с новой версией.
Тесты приёмки и критерии
Примеры тестов:
- Функциональный: проверить, что веб-сервер возвращает 200 на корневой путь.
- Нагрузочный: создать нагрузку и наблюдать, что при увеличении запросов количество Pod’ов масштабируется при включённом HPA.
- Отказоустойчивость: симулировать выключение одного узла и убедиться, что Pod’ы пересозданы на других узлах.
Пример HPA (Horizontal Pod Autoscaler)
HPA автоматически масштабирует количество реплик на основе метрик (CPU, custom metrics). Простой пример:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: nginx-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: nginx
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 50
HPA помогает масштабировать реплики, а Cluster Autoscaler добавляет узлы, если суммарные ресурсы кластера недостаточны.
Стоимость и оценка влияния
При переходе на автоскейлинг учитывайте:
- Стоимость запуска дополнительных VM/инстансов.
- Стоимость балансировщиков и сетевых услуг.
- Возможность использования спотовых/прерываемых инстансов для снижения затрат (но с учётом возможных прерываний).
Impact×Effort: внедрение Kubernetes даёт высокий долгосрочный эффект (управляемость, отказоустойчивость), но требует значительных начальных усилий по настройке и операционной практике.
Галерея крайних случаев
- Stateful-приложения: требуют StatefulSet и внешних томов — не все приложения легко масштабируются горизонтально.
- Образы с большим cold-start временем: частые автоскейлы могут привести к задержкам запуска и потере SLA.
- Региональные сбои: используйте мультизональные кластеры и репликацию данных.
Краткая методология быстрого развертывания (SOP)
- Подготовьте инфраструктуру: выделите мастер и минимум два рабочих узла.
- Установите MicroK8s/k3s или выберите управляемый кластер.
- Настройте CI/CD для сборки и публикации образов.
- Создайте Deployment и Service, настройте Ingress.
- Настройте мониторинг (Prometheus, Grafana) и логирование.
- При необходимости включите HPA и Cluster Autoscaler.
- Проводите регулярные тесты отказоустойчивости и апдейты.
1‑строчный глоссарий
- Pod: минимальная единица выполнения в Kubernetes.
- Deployment: контроллер для управления ReplicaSet и обновлениями.
- Service: стабильная точка доступа к набору Pod’ов.
- HPA: автоматическое масштабирование реплик.
- Cluster Autoscaler: автоматическое изменение количества узлов.
Заключение
Kubernetes облегчает масштабирование Docker-контейнеров на множестве узлов и обеспечивает автоматическое восстановление и распределение нагрузки. Для старта достаточно организовать управляющий узел и минимум два рабочих узла, описать Deployment с нужным количеством реплик и настроить сервисы для доступа. При росте нагрузки включайте HPA и интегрируйте Cluster Autoscaler для динамического добавления узлов.
Завершая, помните: правильный дизайн приложения (stateless, корректные probes, разумные запросы/лимиты) и автоматизация CI/CD — ключ к успешному и предсказуемому масштабированию.
Summary:
- Разверните кластер (управляемый или self-hosted).
- Описывайте рабочие нагрузки через Deployment и Service.
- Масштабируйте количество реплик и при необходимости добавляйте узлы через автоскейлер.
- Следите за безопасностью, мониторингом и затратами.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
