
Извлечение строк из середины файла в Linux
Кратко
Зачем это нужно
Иногда нужно извлечь часть большого файла: дамп базы данных, журнальный фрагмент или подтаблицу из SQL-резервной копии. Прямое редактирование больших файлов неудобно и рискованно; лучше вырезать нужный диапазон и работать с ним отдельно.
Поиск номеров строк
Чтобы понять, какие строки вырезать, сначала найдите номера строк с содержимым, которое вам нужно. Утилита grep с опцией -n выводит номера строк.
grep -n wp_posts howtogeekdb010114.bak | moreПример части вывода показывает номера слева. Команда more предотвращает пролистывание слишком быстрого вывода.
4160:-- Table structure for table `wp_posts`В выводе вы увидите искомую строку и сможете оценить начальный и конечный номера.
Извлечение диапазона с помощью sed
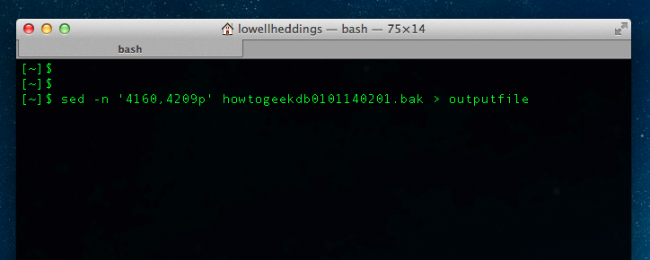
Самый простой и надёжный вариант — sed в режиме печати диапазона:
sed -n '4160,4209p' howtogeekdb0101140201.bak > outputfileСинтаксис обобщённо:
sed -n 'FIRSTLINENUMBER,LASTLINENUMBERp' filename > outputfilenameЧто важно:
- Опция -n отключает автоматическую печать всех строк; без неё sed напечатает весь файл.
- Суффикс p после диапазона говорит «распечатать» только строки в этом диапазоне.
Альтернативные способы
- awk: гибче при фильтрации по условиям, можно задать диапазон по номерам:
awk 'NR>=4160 && NR<=4209' howtogeekdb0101140201.bak > outputfile- head + tail: полезно на небольших файлах — сперва отрезать всё до конца, затем оставить последние N строк:
head -n 4209 filename | tail -n +4160 > outputfileОбратите внимание: tail -n +4160 выводит с 4160-й строки до конца; сочетание head и tail даёт диапазон.
split: разбить файл на части по номеру строки, затем взять нужную часть.
dd: можно копировать участок по байтам, но требует вычисления смещений — редко удобно для текстовых файлов.
редакторы ex/vim: удобны, если вы предпочитаете интерактивное редактирование. Пример в ex:
ex -sc '4160,4209p|q' filename > outputfile- Perl/Python: когда требуется сложная предобработка при извлечении.
Когда метод sed может не подойти
- Файлы с нестандартными кодировками или бинарные файлы: sed может вести себя непредсказуемо.
- Очень большие файлы (десятки гигабайт): sed пройдёт, но производительность и потребление памяти/IO могут стать проблемой; лучше использовать инструменты, оптимизированные для потоковой обработки.
- Нужны условные границы (по тексту, а не по номерам): awk или скрипт будут удобнее.
Шпаргалка команд
- Найти строки с номерами:
grep -n "ключевое_слово" filename- Извлечь диапазон по номерам:
sed -n 'START,ENDp' filename > out- Альтернатива с awk:
awk 'NR>=START && NR<=END' filename > out- head + tail (подходит при небольшом END):
head -n END filename | tail -n +START > outЧек-листы по ролям
Системный администратор
- Сделать резервную копию исходного файла.
- Найти начальную и конечную строки (grep -n).
- Использовать sed/awk для извлечения.
- Проверить целостность извлечённого фрагмента.
- Восстановить права/владение, если нужно при импорте.
Разработчик/аналитик
- Проверить кодировку файла.
- Убедиться, что диапазон захватывает все необходимые заголовки/контейнеры (например, DROP/CREATE в дампе SQL).
- Тестировать импорт на тестовой БД.
Примеры отказов и отладка
- Импорт SQL не проходит: проверьте, включили ли вы все нужные служебные строки (LOCK/UNLOCK, CREATE/DROP). Возможно, в начале/конце диапазона отсутствуют нужные запросы.
- Пустой outputfile: перепроверьте номера строк и кавычки в sed-выражении; кавычки обязательны для защиты запятой в диапазоне.
Критерии приёмки
- Извлечённый файл содержит все ожидаемые строки от START до END включительно.
- Файл открывается в нужной кодировке и импортируется/обрабатывается без ошибок.
- Оригинальный файл не повреждён.
Глоссарий
- NR: в awk — номер текущей обрабатываемой строки.
- sed: потоковый редактор, применяется для поиска и преобразования текста.
- grep: утилита для поиска по шаблону.
Простая методология при работе с большими файлами
- Сделайте резервную копию файла.
- Найдите контекст/шаблон, который определит границы фрагмента (grep -n).
- Извлеките диапазон sed/awk и проверьте содержимое.
- Попробуйте импорт/парсинг на тестовом окружении.
- Если не проходит — расширьте границы или используйте более гибкий инструмент.
flowchart TD
  A[Нужно извлечь текст?] --> B{Есть номера строк?}
  B -- Да --> C[sed -n 'START,ENDp']
  B -- Нет --> D[grep/awk по шаблону]
  D --> E{Нужна логика?}
  E -- Да --> F[awk/Perl/Python]
  E -- Нет --> C
Итоги
sed — простой и надёжный инструмент для извлечения строк по номерам. Если нужно больше гибкости, используйте awk или скрипты. Для больших файлов учитывайте производительность и всегда делайте резервные копии.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
