
Как ограничить вывод grep в Linux
Быстрые ссылки
- Ограничение вывода с помощью grep -m
- Использование head для ограничения вывода grep
grep — утилита в Linux для поиска по тексту. По умолчанию она печатает каждую строку, содержащую совпадение. Если вам важен только первый совпавший результат или фиксированное число результатов, стоит ограничить вывод.
Ограничение вывода с помощью grep -m
Параметр
-mили
--max-countпозволяет показать не более N совпадающих строк. Это часто решает задачу «только первый результат». Полезно комбинировать с флагом
-nдля вывода номеров строк.
grep -m 1 "foo" file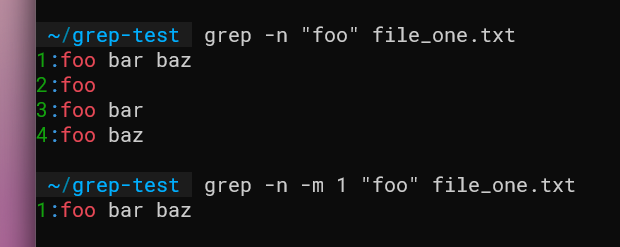
Важно понимать ограничения этого подхода:
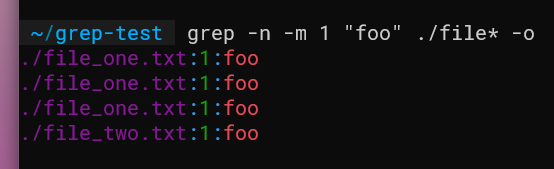
- grep прекращает обработку после N найденных строк, но считает строки, а не совпадения. Если в одной строке несколько совпадений (например, при использовании -o), они не увеличат счётчик строк, и вы можете увидеть меньше совпадений, чем ожидали.
- Ограничение применяется отдельно к каждому файлу. При поиске в нескольких файлах grep выведет до N совпадающих строк для каждого файла.
Использование head для ограничения вывода grep
Альтернатива — передать вывод grep в команду head, которая отрежет поток после N строк. Это ограничение уже будет работать на общий вывод, независимо от числа файлов.
grep "foo" file_one.txt | head -1Плюсы и минусы такого подхода:
- Плюс: работает с флагом -o — вы получите ровно первую строку результата независимо от того, из какого файла она пришла.
- Минус: grep уже отработает для всех файлов, если вы не попросите его остановиться. Поэтому полезно комбинировать: grep -m 1 внутри одного большого файла и head для общей фильтрации.
grep -m 1 "foo" big_file.txt | head -1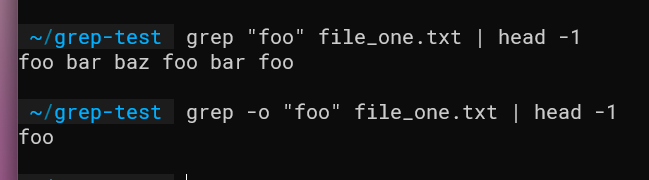
Когда вы обрабатываете несколько файлов, будьте внимательны: head вернёт первую строку из общего потока, а порядок вывода grep зависит от порядка обработки файлов. Если порядок важен, отсортируйте список файлов заранее или используйте детерминированный способ передачи имён в grep.
ls -1v *.log | xargs grep "foo" | head -1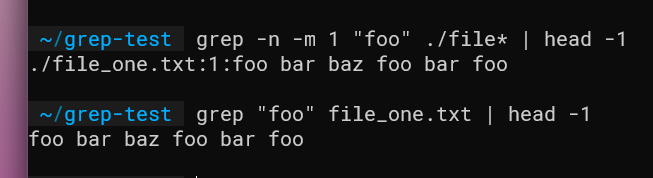
Когда такой подход может не сработать
- Если нужно первое совпадение в каждом файле, но вы используете head — получится только одно совпадение в общем потоке. Используйте grep -m 1 для каждой цели.
- Если строка содержит несколько совпадений и вы используете -o, то grep -m подсчитывает строки, а не отдельные совпадения.
- При работе с очень большими файлами без -m grep может прочитать весь файл до конца, что затратно по времени.
Альтернативные подходы и советы
- Для первого совпадения в файле: grep -m 1.
- Для первого совпадения среди всех файлов: grep … | head -1.
- Для детерминированного порядка файлов: ls -1v или find … -print0 + sort, затем xargs -0.
- Для поиска по бинарным или очень большим файлам: ripgrep (rg) обычно быстрее и имеет похожие опции.
Шпаргалка — часто используемые команды
# Первый совпадающий фрагмент в одном файле
grep -m 1 "pattern" file

# Первый совпадающий фрагмент среди всех файлов
grep "pattern" * | head -1

# Первые N совпадений в каждом файле
grep -m N "pattern" files...

# Печать только совпадающих частей и взять первое
grep -o "pattern" file | head -1

# Отсортировать файлы по имени и затем искать, чтобы получить детерминированный первый результат
ls -1v *.txt | xargs grep "pattern" | head -1
Роль‑ориентированный чеклист
- Для разработчика: использовать -n при отладке, добавлять -o для извлечения совпадающих фрагментов.
- Для системного администратора: применять -m для больших логов, комбинировать с head при агрегации из нескольких файлов.
- Для аналитика: сортировать входные файлы, если нужен воспроизводимый первый результат.
Короткие определения
- grep: утилита для поиска текста по шаблону.
- -m N: остановить после N совпадающих строк на файл.
- -o: печатать только совпавшие фрагменты (по одному на строку).
- head -N: вывести первые N строк потока.
Краткое резюме
Используйте grep -m 1, когда вам нужен первый совпадающий результат на файл. Используйте head, чтобы ограничить общий поток результатов. Часто лучше комбинировать оба подхода: -m уменьшит работу по файлам, а head даст глобальную границу вывода.
Важно: подумайте о порядке обработки файлов и о разнице между «строкой» и «совпадением» при использовании -o.
Ключевые советы: комбинируйте инструменты, сортируйте входные файлы при необходимости и тестируйте команды на небольших примерах перед запуском на больших данных.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
