
Работа с CSV в Bash на Linux
TL;DR
CSV — простой текстовый формат для табличных данных, но при реальных данных (встроенные запятые, кавычки, пропуски) парсер на чистом Bash быстро ломается. Для надёжной работы используйте специализированные утилиты (csvkit, Miller), проверяйте и санитизируйте данные в редакторе таблиц или с помощью скриптов, а для сложных задач переходите на Python с модулем csv. В статье — практические примеры, безопасная методика обработки, плейбук и чек-листы.
Быстрые ссылки
Что такое CSV?
Пример данных
Разбор CSV в Bash
Выбор полей
Ограничения простых парсеров
Набор утилит csvkit
Безопасная очистка CSV
Где вы увидите CSV чаще всего
Что такое CSV?
CSV (Comma Separated Values) — это текстовый формат для табличных данных, где поля в одной строке разделяются разделителем (по умолчанию запятой “,”). CSV — частный случай данных с разделителями. Файлы CSV человекочитаемы: их можно открыть в любом текстовом редакторе, просмотреть через less и перемещать между приложениями.
Определение термина: CSV — текстовый файл, где каждая строка соответствует записи, а поля разделены запятой или другим указанным разделителем.
Важно понимать: CSV прост внешне, но в реальности содержит поле для хитростей — в нём могут встречаться запятые в данных, кавычки внутри полей и пустые значения.
Связанный материал: что такое CSV и как его открыть в разных приложениях.
Пример данных
Можно быстро сгенерировать тестовый CSV на сайтах типа Online Data Generator. В статье взят файл с 50 строками фиктивных данных сотрудников со следующими полями:
- id: уникальный целочисленный идентификатор
- firstname: имя
- lastname: фамилия
- job-title: должность
- email-address: электронная почта
- branch: филиал компании
- state: штат/регион
Некоторые CSV содержат строку заголовка; наш файл тоже. Вверху файла могут выглядеть так:
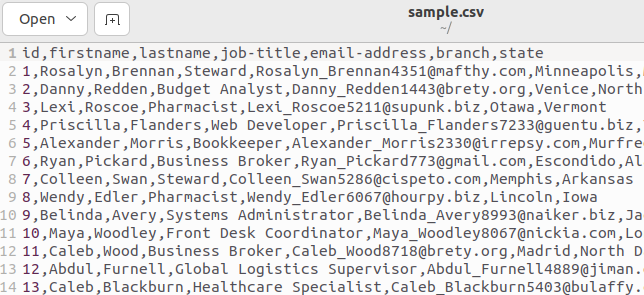
Первая строка содержит имена полей через запятую.
Разбор данных из CSV в Bash
Ниже пример простого скрипта, который читает CSV и распаковывает поля в переменные. Сохраните его как field.sh.
#! /bin/bash

while IFS="," read -r id firstname lastname jobtitle email branch state

do

echo "Record ID: $id"

echo "Firstname: $firstname"

echo " Lastname: $lastname"

echo "Job Title: $jobtitle"

echo "Email add: $email"

echo " Branch: $branch"

echo " State: $state"

echo ""

done < <(tail -n +2 sample.csv)
Ключевые моменты скрипта:
- while — читает построчно.
- IFS=”,” — временно ставит запятую как внутренний разделитель полей (Internal Field Separator).
- read -r — сохраняет обратные слеши как обычные символы.
- tail -n +2 — пропускает заголовок (начинает с второй строки).
- <(…) — process substitution: позволяет направить вывод команды как входной поток для цикла.
Сделайте скрипт исполняемым:
chmod +x field.shЗапуск:
./field.sh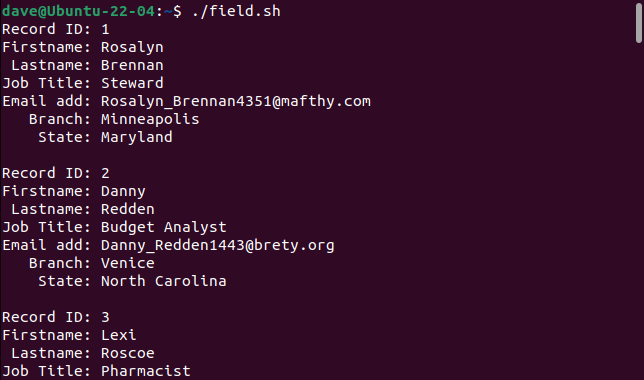
Выбор полей
Если нужно получить не все поля, а только некоторые, добавим cut. Скрипт select.sh:
#!/bin/bash

while IFS="," read -r id jobtitle branch state

do

echo "Record ID: $id"

echo "Job Title: $jobtitle"

echo " Branch: $branch"

echo " State: $state"

echo ""

done < <(cut -d "," -f1,4,6,7 sample.csv | tail -n +2)
Мы используем cut -d “,” -f1,4,6,7 чтобы выбрать поля 1, 4, 6 и 7 и подать их в read. Это простой и часто удобный приём.
Пример запуска:
./select.sh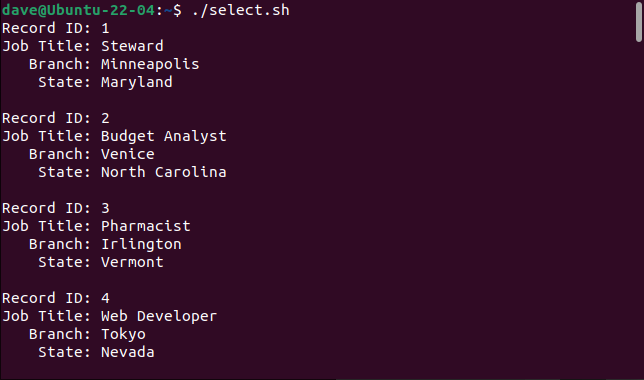
Ограничения простых парсеров
Когда данные просты (нет запятых и кавычек внутри полей), указанные методы работают. Но реальный CSV часто сложнее. Рассмотрим файл sample2.csv с такими строками:
id,firstname,lastname,job-title,email-address,branch,state

1,Rosalyn,Brennan,"Steward, Senior",Rosalyn_Brennan4351@mafthy.com,Minneapolis,Maryland

2,Danny,Redden,"Analyst ""Budget""",Danny_Redden1443@brety.org,Venice,North Carolina

3,Lexi,Roscoe,Pharmacist,,Irlington,Vermont
Проблемы:
- В записи 1 запятая внутри job-title — требуются кавычки вокруг поля.
- В записи 2 внутри job-title встречаются двойные кавычки, которые в CSV экранируются двойным повторением.
- В записи 3 отсутствует значение email-address.
Если запустить наш простой скрипт на sample2.csv, парсинг сдвинется: поле job-title разобъётся на две части, далее все колонки смещаются.
Из-за таких случаев Bash-парсер на основе IFS и cut даёт неверный результат.
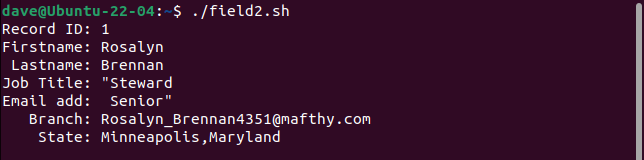
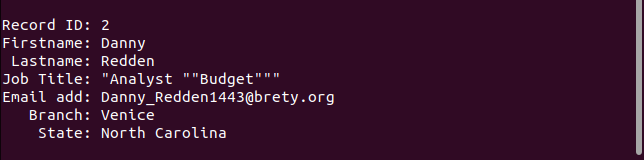

Важно: пытаться написать полностью универсальный CSV-парсер на bash — неблагодарная задача. Инструменты вроде awk помогают, но остаются крайние случаи.
Подходы для реальных случаев
Если у вас жесткие сроки или данные варьируются, два основных подхода:
- Использовать инструмент, который уже умеет корректно читать CSV (csvkit, Miller, Python csv).
- Санитизировать (очистить) данные заранее, чтобы простые скрипты могли работать корректно.
Набор утилит csvkit
csvkit — набор утилит на Python для работы с CSV. Установите через пакетный менеджер вашей системы:
Ubuntu:
sudo apt install csvkitFedora:
sudo dnf install python3-csvkitManjaro:
sudo pacman -S csvkitУтилита csvlook отображает CSV как таблицу, корректно обрабатывая кавычки и запятые внутри полей:
csvlook sample2.csv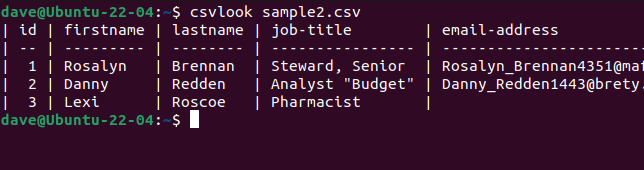
Чтобы выбрать столбцы, используйте csvcut. Опция -c принимает имена столбцов или номера.
Примеры эквивалентных команд:
csvcut -c lastname,firstname,job-title,email-address sample2.csvcsvcut -c lastname,firstname,4,5 sample2.csvcsvcut -c 3,2,4,5 sample2.csv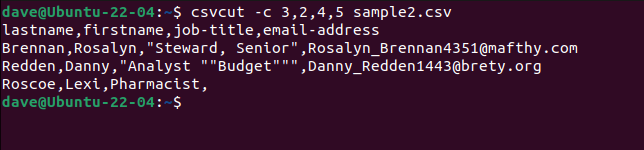
Сортировка с помощью csvsort:
csvcut -c 3,2,4,5 sample2.csv | csvsort -c 1 -rДобавим csvlook для красивого вывода:
csvcut -c 3,2,4,5 sample2.csv | csvsort -c 1 -r | csvlook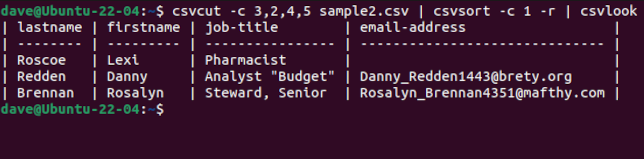
После проверки можно сохранить результат в файл:
csvcut -c 3,2,4,5 sample2.csv > sample3.csvБезопасная очистка CSV
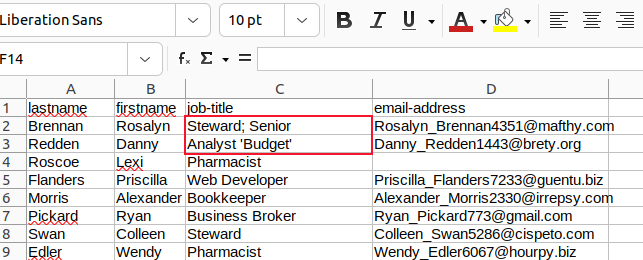
Один из простых способов избавиться от проблемных символов — редактирование в редакторе таблиц (LibreOffice Calc, Excel). При открытии CSV каждая ячейка будет соответствовать полю. Выполните «Найти и заменить» только по содержимому ячеек (не по разделителям):
- Замените запятые внутри данных на другой символ (например, точку с запятой ;) или пробел), если это допустимо.
- Замените двойные кавычки внутри поля на одинарные или апострофы, чтобы не ломать экранирование.
Пример: используйте «Найти» “,” внутри ячеек и «Заменить» на “;”. Будьте внимательны — правило должно применяться только к данным, а не к разделителю CSV.
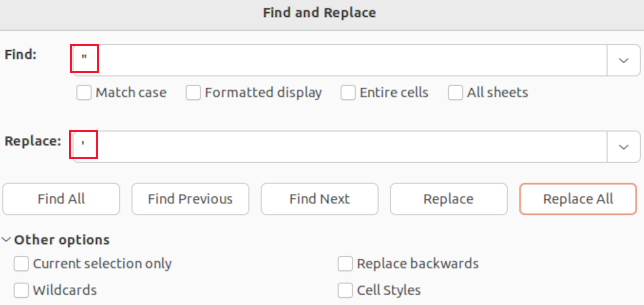
После правок сохраните файл и запустите более простой парсер. В нашем случае мы заменили проблемные символы и получили sample3.csv.
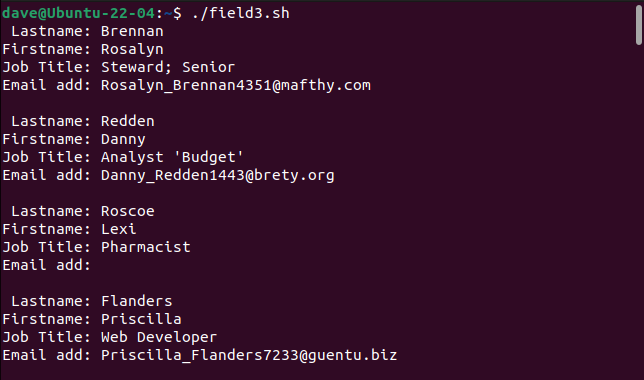
Скрипт field3.sh для sample3.csv:
#! /bin/bash

while IFS="," read -r lastname firstname jobtitle email

do

echo " Lastname: $lastname"

echo "Firstname: $firstname"

echo "Job Title: $jobtitle"

echo "Email add: $email"

echo ""

done < <(tail -n +2 sample3.csv)
Запуск покажет, что парсер корректно разбирает записи после очистки данных.
Альтернативные инструменты и подходы
Если csvkit не подходит или нужен иной стек, рассмотрите:
- Miller (mlr) — очень быстрый инструмент для CSV/TSV/JSON, удобен для сложной фильтрации и преобразований.
- Python с модулем csv — идеально для сценариев, где требуется бизнес-логика при парсинге.
- awk с аккуратными регулярными выражениями — можно близко подобраться, но придётся учитывать экранирование и вложенные кавычки.
- csvtool — маленькая утилита для базовых операций.
Пример: чтение CSV в Python (корректная обработка кавычек и запятых):
#!/usr/bin/env python3

import csv

with open('sample2.csv', newline='') as f:
    reader = csv.DictReader(f)
    for row in reader:
        print(f"{row['lastname']}, {row['firstname']} — {row['job-title']} <{row['email-address']}>")
Python-решение даёт вам полный контроль над экранированием, пропусками и преобразованиями типов.
Методика безопасной обработки CSV (минимальный SOP)
Шаги, которые можно применять как шаблон при обработке CSV:
- Сделайте резервную копию исходного файла.
- Просмотрите первые и последние строки: head/tail или csvlook.
- Определите разделитель и наличие строки заголовка.
- Проверяйте наличие незакрытых кавычек и смешанных строк: используйте csvtool или csvkit для валидации.
- Если данные содержат проблемные символы, санитизируйте их в редакторе таблиц или автоматически (скрипт замены внутри полей).
- Примените итоговую обработку (csvcut, csvsort, mlr, Python) и проверьте результат (csvlook).
- Создайте тестовые записи с краевыми случаями и прогоните их через выбранный процесс.
- Задокументируйте формат и соглашения по полям для следующих экспортов.
Критерии приёмки
- Все обязательные поля корректно определены.
- Нет смещённых колонок из-за незакрытых кавычек.
- Количество столбцов одинаково во всех строках после обработки.
- Появившиеся пустые значения обработаны явно (NULL, пустая строка или дефолт).
Сценарии отказа и как с ними справляться
Когда стандартный подход не работает:
- Если встречаются разные разделители в одном файле — попытайтесь определить обычный разделитель по статистике (например, большинство строк имеет N разделителей). Если не удаётся — запросите исходные данные или предварительную конвертацию.
- Если файл содержит вложенные CSV или JSON в полях — используйте mlr или Python и применяйте парсинг вложенного формата отдельно.
- Если файл слишком большой для ручной валидации — используйте стриминговый парсинг и выборочную проверку (например, проверять первые 10 000 строк и случайный сэмпл).
Шпаргалка команд и приёмы
- Просмотреть первые строки: head -n 10 sample.csv
- Просмотреть последние: tail -n 10 sample.csv
- Пропустить заголовок: tail -n +2
- Выбрать колонки: csvcut, cut
- Отформатировать для чтения: csvlook
- Сортировать: csvsort
- Быстрая проверка валидности: csvclean (из csvkit)
Тест-кейсы и критерии приёмки
Минимальный набор тестов при написании процесса обработки CSV:
- Запись с запятой внутри поля — должна корректно попадать в одно поле.
- Запись с двойными кавычками внутри поля — должна парситься и экранироваться.
- Пустые поля в середине строки — не должны смещать последующие поля.
- Строки с разным количеством столбцов — должны быть выявлены и зафиксированы как ошибки.
- Очень длинные значения в поле — не должны ломать парсер.
Критерий приёмки: все тесты проходят, либо для непреодолимых случаев — есть зафиксированная причина и план корректировки данных.
Чек-лист по ролям
Для аналитика данных:
- Проверьте структуру заголовка.
- Зафиксируйте словарь полей и примеры значений.
- Оцените необходимость санитизации и сообщите владельцу данных.
Для разработчика скриптов:
- Используйте готовые библиотеки для парсинга.
- Напишите тесты на крайние случаи.
- Логируйте и возвращайте понятные ошибки при неконсистентных данных.
Для системного администратора:
- Контролируйте версии утилит (csvkit, mlr, Python).
- Настройте автоматическое резервное копирование исходных файлов.
- Ограничивайте права доступа к конфиденциальным CSV.
Мини-методология принятия решения
- Если задача одноразовая и данные небольшие — sanitisize в LibreOffice и используйте простые Bash-скрипты.
- Если задача повторяется или данные варьируются — используйте csvkit или Python.
- Если нужны сложные преобразования и высокая скорость — рассмотрите Miller (mlr).
Дерево принятия решения (Mermaid)
flowchart TD
    A[Есть CSV] --> B{Файл малый и одноразовый?}
    B -->|Да| C[Открыть в LibreOffice, санитизировать]
    B -->|Нет| D{Нужна быстрая обработка и фильтрация?}
    D -->|Да| E[Использовать mlr]
    D -->|Нет| F{Нужна гибкая логика?}
    F -->|Да| G[Использовать Python csv]
    F -->|Нет| H[Использовать csvkit]
    C --> I[Запустить Bash-скрипт]
    E --> I
    G --> I
    H --> I
Примеры реальных приёмов и паттернов
- Нормализация разделителя: если экспорт идёт из Excel и локаль использует запятую как десятичный разделитель, выбирайте табуляцию или точку с запятой при экспорте.
- Экранирование кавычек: внутренние кавычки в CSV экранируются двойным повторением (“” → “). Убедитесь, что парсер это поддерживает.
- Обработка пропусков: используйте явные метки (NULL) или договоритесь с потребителем данных о формате пустых полей.
Советы по безопасности и приватности
- CSV часто содержит персональные данные. Обеспечьте соответствующие права доступа к файлам.
- При пересылке CSV удаляйте или маскируйте чувствительные поля (email, персональные идентификаторы), если это требуется политикой конфиденциальности.
- Если данные под GDPR, документируйте основания обработки и сроки хранения.
Когда не использовать Bash
- Когда CSV содержит вложенные кавычки и сложные экранирования.
- Когда нужен атомарный и валидационный проход по строкам с отчетом об ошибках.
- Когда нужно обслуживать очень большие файлы с ограничением памяти — лучше использовать стриминговые инструменты на Python или Miller.
Итоги и рекомендации
- CSV прост, но полон подводных камней: встроенные запятые, экранирование кавычек и пропуски — главные источники проблем.
- Для безопасной обработки используйте специализированные утилиты (csvkit, mlr) или стандартные библиотеки Python.
- Если хотите оставаться в экосистеме Bash — предварительно санитизируйте данные в LibreOffice или автоматизированно, затем применяйте cut, csvcut и простые скрипты.
- Всегда делайте резервную копию исходных файлов и покрывайте процесс тестами на краевые случаи.
Важно: CSV встречается повсюду — освоение практик по его обработке сильно упростит обмен данными между командами и приложениями.
Краткое резюме
- CSV — универсальный формат, но не тривиальный в надёжном парсинге.
- csvkit и mlr помогают решить большинство проблем без написания сложных парсеров.
- Для повторяемых и критичных конвейеров используйте Python с csv или Pandas и автоматические тесты.
1-строчный глоссарий
- IFS: переменная окружения Bash, задающая разделители полей.
- csvkit: набор утилит на Python для работы с CSV.
- csvlook: команда из csvkit для красивого вывода таблицы.
- mlr: Miller — инструмент для манипуляции с таблицами (CSV/TSV/JSON).
Сопроводительные материалы
- Чек-лист внедрения: резервная копия → проверка заголовка → выбор инструмента → тесты → запуск в прод
- Шпаргалка команд: head, tail, cut, csvcut, csvsort, csvlook, csvclean
Спасибо за внимание. Вопросы по конкретным сценариям или примерам данных — пишите, помогу подобрать оптимальный рабочий поток.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
