
Установка Apache Spark на Debian 11
Введение
Apache Spark — это бесплатный, открытый и распределённый фреймворк общего назначения для быстрой обработки данных. Он поддерживает API для потоковой обработки, графов и пакетной обработки на Java, Python, Scala и R. Spark можно запускать в кластере Hadoop или в автономном (standalone) режиме.
В этом руководстве описаны шаги по установке Apache Spark на сервер с Debian 11.
Кому полезно это руководство
- Системным администраторам и инженерам данных, которые хотят быстро развернуть Spark.
- Девопсам, которым нужен standalone-кластер для тестов и небольших задач.
- Разработчикам, желающим локально запускать Spark-приложения.
Требования
- Сервер с Debian 11.
- Доступ root или пользователь с sudo-привилегиями.
Установите Java
Apache Spark написан на Java, поэтому на системе должен быть установлен JDK.
Установите OpenJDK и curl командой:
apt-get install default-jdk curl -yПроверьте версию Java:
java --versionОжидаемый пример вывода:
openjdk 11.0.12 2021-07-20
OpenJDK Runtime Environment (build 11.0.12+7-post-Debian-2)
OpenJDK 64-Bit Server VM (build 11.0.12+7-post-Debian-2, mixed mode, sharing)
Важно: Spark требует совместимой версии JDK (как правило, 8 или 11 для версий Spark 3.x). Если у вас другая версия Java, проверьте требования совместимости для конкретной версии Spark.
Загрузка и установка Apache Spark
На момент написания этого руководства актуальная версия — 3.1.2. Скачайте архив:
wget https://dlcdn.apache.org/spark/spark-3.1.2/spark-3.1.2-bin-hadoop3.2.tgzРаспакуйте архив:
tar -xvzf spark-3.1.2-bin-hadoop3.2.tgzПереместите распакованную директорию в /opt:
mv spark-3.1.2-bin-hadoop3.2/ /opt/sparkДобавьте переменные окружения Spark в ваш профиль. Откройте ~/.bashrc:
nano ~/.bashrcДобавьте следующие строки в конец файла:
export SPARK_HOME=/opt/spark
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
Сохраните файл и примените изменения:
source ~/.bashrcПримечание: вместо ~/.bashrc можно использовать /etc/profile.d/spark.sh для глобальной настройки для всех пользователей.
Запуск Apache Spark (master и worker)
Запустите master-сервис:
start-master.shОжидаемый вывод:
starting org.apache.spark.deploy.master.Master, logging to /opt/spark/logs/spark-root-org.apache.spark.deploy.master.Master-1-debian11.outПо умолчанию мастер слушает на порту 8080. Проверить можно так:
ss -tunelp | grep 8080Пример вывода:
tcp LISTEN 0 1 *:8080 *:* users:(("java",pid=24356,fd=296)) ino:47523 sk:b cgroup:/user.slice/user-0.slice/session-1.scope v6only:0Запустите worker, указывая адрес мастера (замените your-server-ip на IP или имя хоста мастера):
start-slave.sh spark://your-server-ip:7077Доступ к веб-интерфейсу
Откройте в браузере:
http://your-server-ip:8080Вы увидите список мастера и воркеров в веб-интерфейсе:
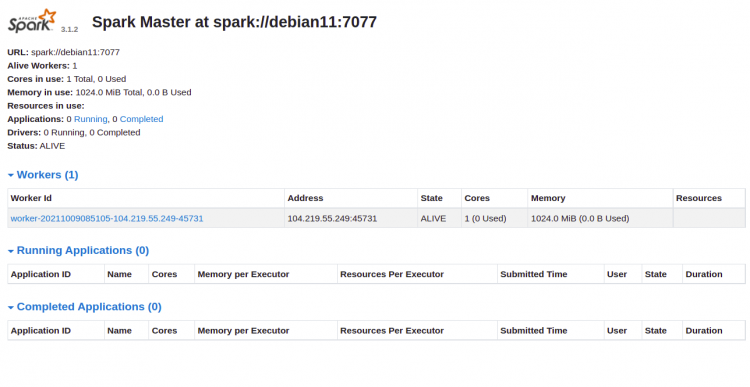
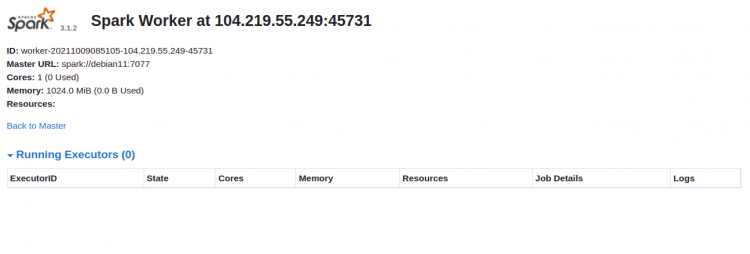
Нажмите на ID воркера, чтобы увидеть подробности:
Подключение к Spark через командную строку
Для интерактивной работы на Scala выполните:
spark-shellОжидаемый интерфейс и приветствие (пример):
Spark session available as 'spark'.
Welcome to
      ____              __
     / __/__  ___ _____/ /__
    _\ \/ _ \/ _ `/ __/  '_/
   /___/ .__/\_,_/_/ /_/\_\   version 3.1.2
      /_/

Using Scala version 2.12.10 (OpenJDK 64-Bit Server VM, Java 11.0.12)
Type in expressions to have them evaluated.
Type :help for more information.

scala>
Для работы с Python используйте pyspark. Установите Python (если ещё не установлен):
apt-get install python -yЗапустите консоль PySpark:
pysparkПример приветствия PySpark:
Welcome to
      ____              __
     / __/__  ___ _____/ /__
    _\ \/ _ \/ _ `/ __/  '_/
   /__ / .__/\_,_/_/ /_/\_\   version 3.1.2
      /_/

Using Python version 3.9.2 (default, Feb 28 2021 17:03:44)
Spark context Web UI available at http://debian11:4040
Spark context available as 'sc' (master = local[*], app id = local-...).
SparkSession available as 'spark'.
>>>
Остановка мастера и воркера
Остановите воркер:
stop-slave.shОстановите мастер:
stop-master.shПрактические рекомендации и безопасность
- Не запускайте Spark от root в production. Создайте отдельного пользователя spark:
adduser --system --no-create-home --group spark
chown -R spark:spark /opt/spark- Закрывайте порты мастер/воркер в брандмауэре, разрешая доступ только из доверенной сети.
- Откройте порты 7077 (Spark RPC), 8080 (мастер UI) и 4040 (приложение UI по умолчанию) только для админов.
- Для долгоживущего и надёжного запуска создайте systemd-сервисы для master и worker (пример ниже).
Пример systemd unit для spark-master.service:
[Unit]
Description=Apache Spark Master
After=network.target

[Service]
Type=forking
User=spark
Group=spark
Environment=SPARK_HOME=/opt/spark
ExecStart=/opt/spark/sbin/start-master.sh
ExecStop=/opt/spark/sbin/stop-master.sh
Restart=on-failure

[Install]
WantedBy=multi-user.target
После создания юнита выполните:
systemctl daemon-reload
systemctl enable --now spark-master.service
Повторите аналогично для spark-worker.service, подставив команду start-slave.sh с указанием мастера.
Советы по производительности и конфигурации
- Настройте spark-defaults.conf и spark-env.sh для управления памятью (spark.executor.memory, spark.driver.memory) и количеством ядер.
- Для продакшена используйте YARN или Kubernetes как менеджер ресурсов для масштабируемости и управления инстансами.
- Мониторьте Web UI и лог-файлы в /opt/spark/logs для поиска узких мест.
Альтернативные подходы к запуску Spark
- Spark в режиме YARN (интеграция с Hadoop): лучше для существующих Hadoop-кластеров.
- Spark на Kubernetes: подходит для облачных и контейнеризированных окружений.
- Управляемые сервисы (Databricks, EMR): минимизируют операционную нагрузку, но платные.
Таблица совместимости — базовые указания
- Java: OpenJDK 8 или 11 обычно совместимы с Spark 3.x.
- Scala: набор версий ограничен версией сборки Spark (обычно 2.12 для Spark 3.1.x).
- Hadoop: используйте сборку Spark, совместимую с вашей версией Hadoop (в нашем примере — hadoop3.2).
Критерии приёмки
- Master слушает на 8080 и доступен по HTTP.
- Worker зарегистрирован в Web UI и имеет состояние ALIVE.
- spark-shell и pyspark запускаются без ошибок.
- Запуск простого примера (parallelize и count) возвращает ожидаемый результат.
Пример минимального теста в spark-shell:
scala> val data = sc.parallelize(1 to 100)
scala> data.count()
res0: Long = 100
Частые проблемы и их решения
- Java не найдена: установите JDK и проверьте PATH.
- Порт 8080 занят: проверьте процессы ss -tunelp и измените порт в spark-env.sh.
- Worker не подключается: проверьте сетевую доступность мастера и правильность URL (spark://your-server-ip:7077).
- Права доступа к /opt/spark: присвойте владельца spark пользователю.
Чек-лист по ролям
- Администратор:
- Установил JDK и curl.
- Настроил пользователя spark и права на /opt/spark.
- Создал systemd-юниты и настроил firewall.
- DevOps:
- Проверил мониторинг Web UI и логи.
- Настроил резервное копирование конфигураций.
- Инженер данных:
- Запустил spark-shell и pyspark.
- Прогнал тестовый job и проверил Web UI приложения.
Короткая методология развертывания (шаги)
- Установить JDK и необходимые утилиты. 2. Скачать и распаковать Spark. 3. Настроить переменные окружения. 4. Создать сервисного пользователя. 5. Запустить master и worker. 6. Настроить systemd и firewall. 7. Протестировать.
Резюме
Вы установили Apache Spark на Debian 11, запустили мастер и воркер, получили доступ к веб-интерфейсу и выполнили базовую проверку работы через spark-shell и pyspark. Для продуктивного использования рекомендовано настроить systemd-сервисы, ограничить доступ с помощью брандмауэра и запускать Spark не от root.
Важно: для продакшн-развертываний рассмотрите интеграцию со средствами управления ресурсами (YARN/Kubernetes) и централизованный сбор логов и метрик.
Если нужно, могу добавить sample systemd-файл для воркера, пример конфигураций spark-defaults.conf или краткий playbook для автоматизации (Ansible).

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
