
Создание оповещения CloudWatch для SQS
Коротко: CloudWatch автоматически собирает метрики для очередей SQS каждую минуту. В статье мы создаём оповещение на метрику NumberOfMessagesSent и показываем лучшие практики по настройке порогов, проверке и отработке инцидентов.
Краткое описание метрик SQS в CloudWatch
Определения — одна строка для каждой метрики.
- ApproximateAgeOfOldestMessage: примерный возраст старейшего не удалённого сообщения в очереди в секундах.
- ApproximateNumberOfMessagesDelayed: количество сообщений, которые отложены и сейчас недоступны для чтения.
- ApproximateNumberOfMessagesNotVisible: количество сообщений «в полёте» (уже выданы клиенту, но не удалены).
- ApproximateNumberOfMessagesVisible: количество сообщений, доступных для получения из очереди.
- NumberOfEmptyReceives: число вызовов ReceiveMessage, которые не вернули сообщений.
- NumberOfMessagesDeleted: число сообщений, удалённых из очереди.
- NumberOfMessagesReceived: число сообщений, возвращённых вызовами ReceiveMessage.
- NumberOfMessagesSent: число сообщений, добавленных в очередь.
- SentMessageSize: объём (размер) сообщений, добавленных в очередь.
Важно: метрики обновляются каждую минуту. Для агрегатов (Sum, Average и т. п.) выбирайте период и число проверок в зависимости от допустимой задержки и допустимого уровня шума.
Требования
- Аккаунт AWS (создайте при необходимости).
- Наличествует одна активная очередь SQS.
- SNS Topic с подпиской для получения уведомлений.
Что мы сделаем
- Войдём в AWS Management Console.
- Создадим оповещение CloudWatch на метрику NumberOfMessagesSent для выбранной очереди SQS.
Вход в AWS
Перейдите в консоль управления AWS и выполните вход под вашей учётной записью.
После входа выберите регион в верхнем правом углу консоли.
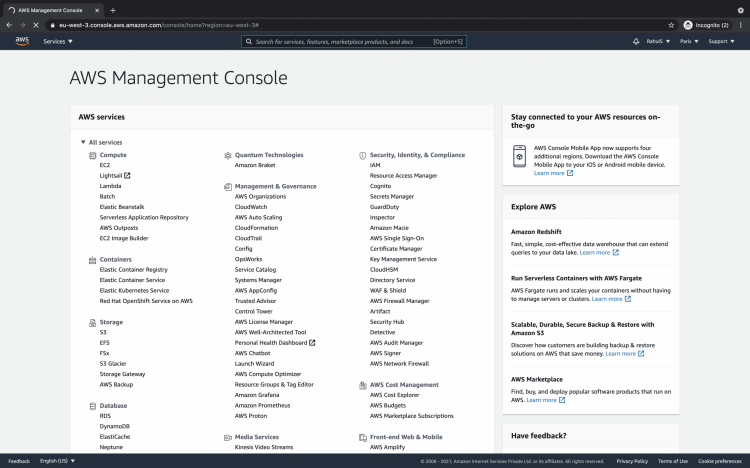
Создание оповещения для очереди SQS
- В строке поиска вверху введите CloudWatch и перейдите в сервис CloudWatch.
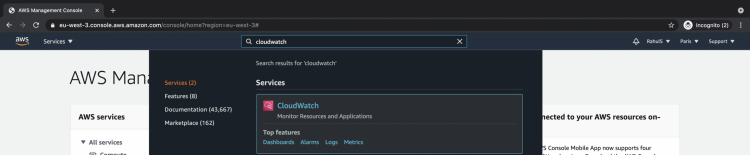
- Откроется панель CloudWatch — обзор и навигация.
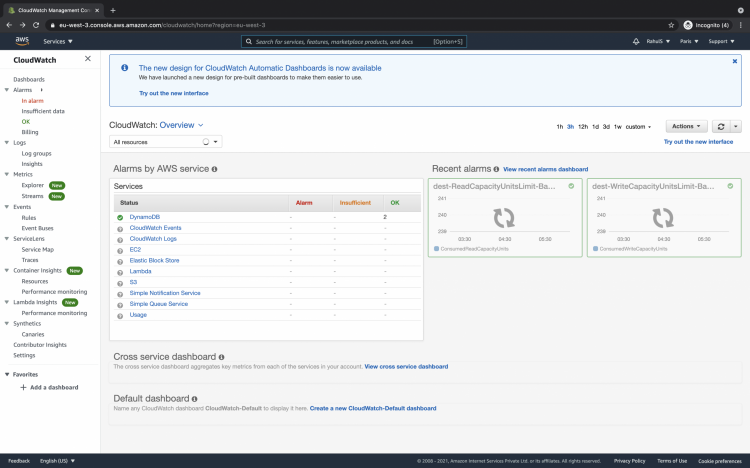
- В меню слева выберите “Alarms” (Оповещения).
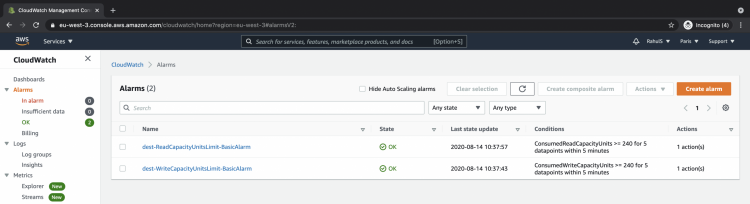
- Нажмите кнопку “Create alarm”.
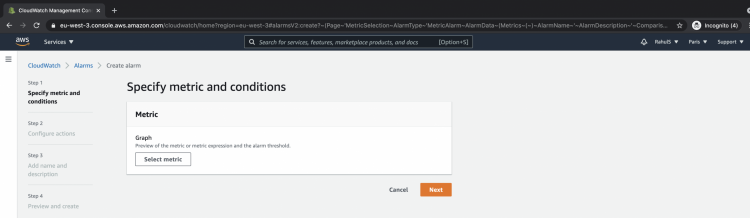
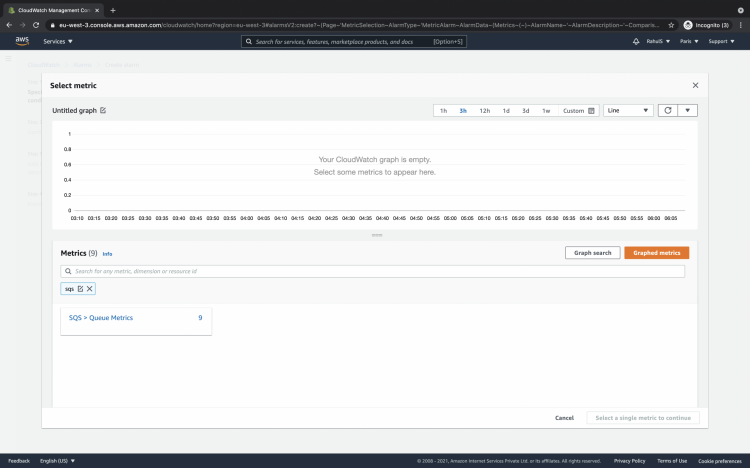
- Нажмите “Select metric” и в списке сервисов найдите SQS → Queue metrics.
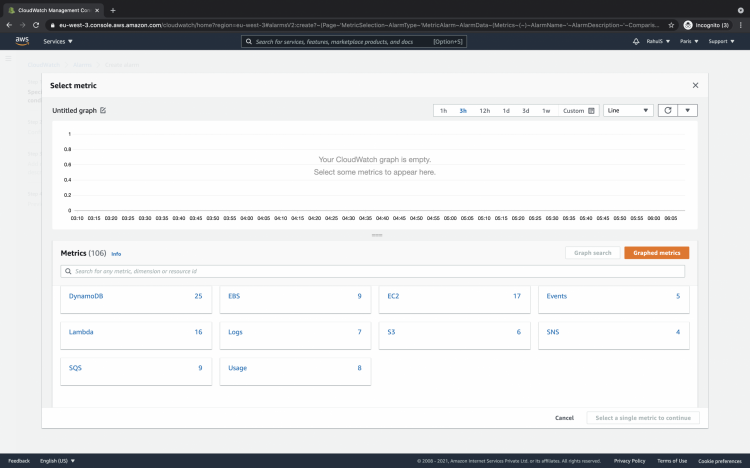
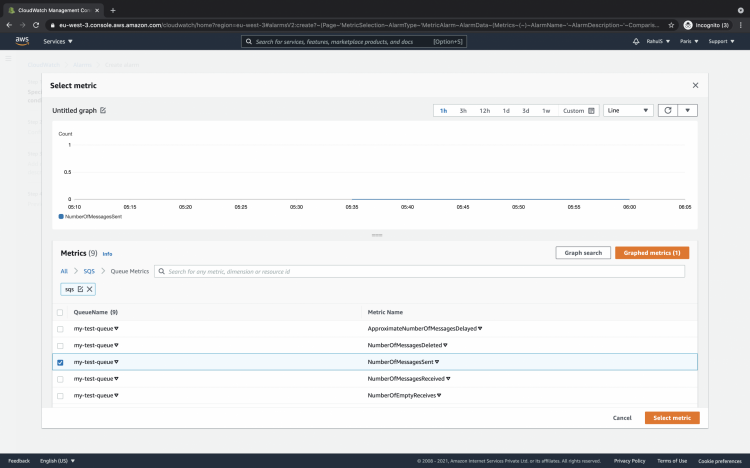
- Выберите метрику NumberOfMessagesSent для нужной очереди и нажмите “Select metric”.
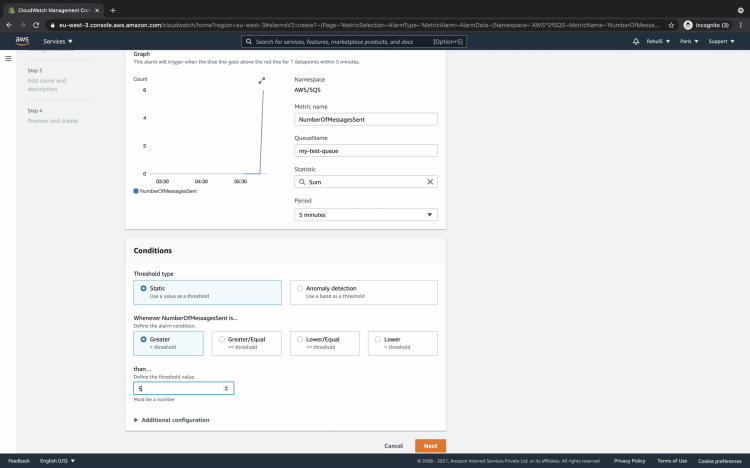
- Укажите статистику, тип порога, условие и значение порога. В примере мы используем Sum > 5 за 5 минут: оповещение сработает, если сумма сообщений за 5 интервалов по 1 минуте превысит 5.
Советы по выбору агрегации и периода:
- Sum подходит для подсчёта количества событий за интервал.
- Average удобен для средней нагрузки по времени.
- Выбирайте период (Period) 1 минуту при необходимости быстрой реакции, 5 минут — для сглаживания всплесков.
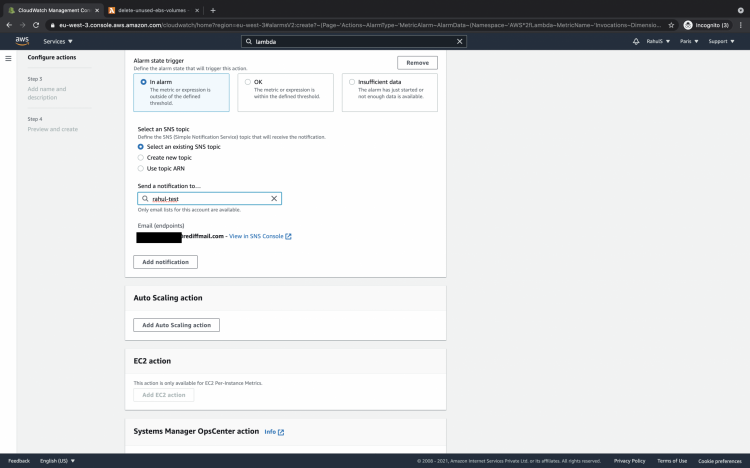
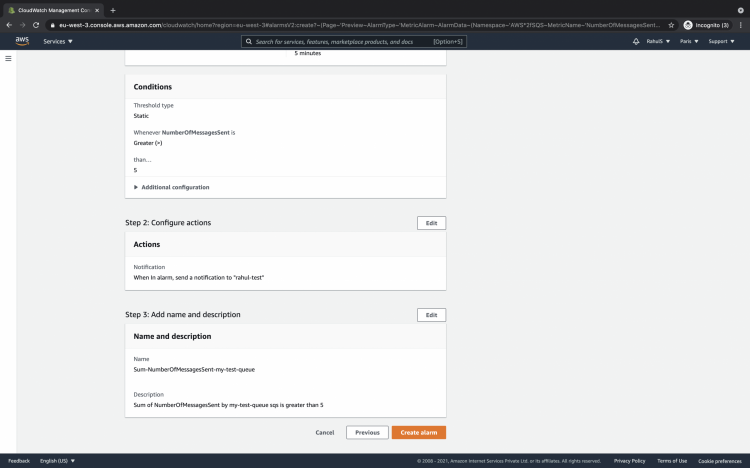
- Настройте действия (Actions): укажите Alarm state trigger и выберите SNS Topic, на который придёт уведомление.
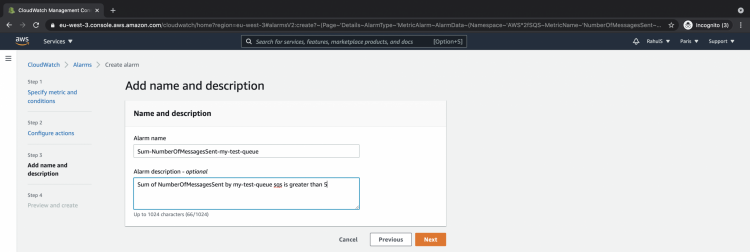
- Дайте имя и описание оповещению и нажмите “Next”.
- Просмотрите конфигурацию и нажмите “Create alarm”.
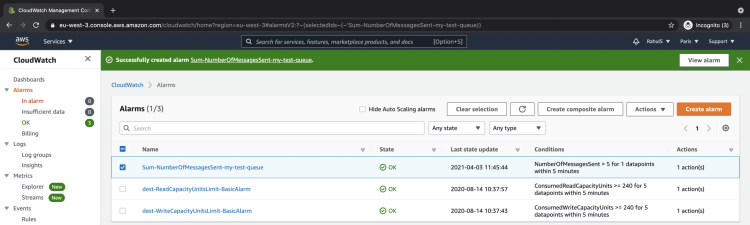
- Готово — теперь вы увидите созданное оповещение. Состояние будет меняться в зависимости от порога и поведения очереди.
Проверка и тестирование (рекомендованные шаги)
- Отправьте в очередь N сообщений (например, 6) и ожидайте агрегирование за выбранный период.
- Проверьте, что в CloudWatch изменилось значение метрики NumberOfMessagesSent.
- Убедитесь, что SNS Topic получает уведомления (проверьте подписки и доставку).
- Тестируйте сценарии с частыми короткими всплесками и с низкой, но стабильной нагрузкой.
Критерии приёмки
- Оповещение создаётся без ошибок.
- При искусственной генерации нагрузки оповещение переходит в состояние ALARM в ожидаемое время.
- SNS Topic отправляет уведомление подписчикам (email, Lambda, HTTP endpoint).
- Ложных срабатываний нет при нормальной рабочей нагрузке.
Лучшие практики и настройка порогов
- Начните с более консервативных порогов, чтобы избежать шума. Уменьшайте порог постепенно.
- Используйте более длинный период агрегации для устойчивых сервисов и короткий — если важна быстрая реакция.
- Применяйте прерывание оповещений (suppression) в периоды плановой нагрузки (maintenance windows).
- Комбинируйте метрики: метрики очереди + аппликационные метрики (через CloudWatch custom metrics) дают более точную картину.
Когда оповещение может не помочь (контрпримеры)
- Если проблема — в потребителях очереди (worker), а не в количестве входящих сообщений, оповещение на NumberOfMessagesSent даст только косвенный сигнал.
- Если сообщения быстро обрабатываются и нагрузка мимолётна (меньше периода агрегации), оповещение может не сработать.
- При отсутствии корректных подписок в SNS уведомления будут теряться — проверяйте доставку.
Альтернативные подходы
- Metric Math: комбинируйте несколько метрик в одном выражении, например отношение NotVisible/Visible.
- Lambda + Custom Metrics: публикуйте дополнительные метрики (latency, error-rate) от приложения.
- EventBridge: для более сложной маршрутизации событий и автоматизации реакций.
- Сторонние системы мониторинга (Datadog, Prometheus + Grafana) для продвинутой аналитики.
Мини-методология настройки оповещений (шаги)
- Определите цель оповещения (что хотите обнаруживать).
- Выберите метрику и статистику (Sum/Average/Max).
- Выберите период и количество периодов для оценки.
- Настройте действия (SNS/Lambda/Auto Scaling/Runbook).
- Протестируйте, откалибруйте порог, задокументируйте.
Ролевые чеклисты
SRE / On-call:
- Убедиться, что оповещения имеют понятные имена и runbook.
- Настроить эскалацию и контактные данные.
Developer:
- Проверить, что компоненты приложения генерируют сообщения корректно.
- Написать тесты, имитирующие входящий трафик.
DevOps / Platform:
- Проверить, что SNS Topic подписан и доставляет уведомления.
- Настроить мониторинг доставки уведомлений.
Шаблон: чеклист создания оповещения
- Выбрана метрика (имя + очередь).
- Указана статистика (Sum/Average/Max).
- Период и количество периодов установлены.
- Настроены действия (SNS / Lambda / Auto-scaling).
- Имя и описание оповещения заданы.
- Проверена доставка уведомлений и реакции автоматизаций.
Decision tree для выбора типа реакции (Mermaid)
flowchart TD
  A[Превышение порога обнаружено] --> B{Сообщения накапливаются?}
  B -- Да --> C[Отправить уведомление SRE и запустить Auto-scaling]
  B -- Нет --> D{Есть ошибки обработки 'increase in NotVisible'?}
  D -- Да --> E[Отправить уведомление Dev team и запустить диагностику]
  D -- Нет --> F[Логировать и наблюдать; возможно ложное срабатывание]
Короткий runbook на случай ALARM
- Получить уведомление и открыть консоль CloudWatch.
- Просмотреть графики NumberOfMessagesSent, ApproximateNumberOfMessagesVisible, ApproximateNumberOfMessagesNotVisible.
- Проверить логи consumer-ов и метрики обработки (latency, errors).
- При необходимости масштабировать consumers или проверить причину всплеска сообщений.
- После решения инцидента задокументировать выводы и скорректировать порог.
Тестовые случаи и критерии приёмки
- Ввести 6 сообщений за 1 минуту: оповещение должно перейти в ALARM в пределах 1–2 периодов (в зависимости от настройки).
- Снять нагрузку: оповещение должно вернуться в OK после 5 минут (или настроенного времени восстановления).
- Проверить доставку SNS: подписчик получает уведомление при ALARM.
Безопасность и конфиденциальность
- Ограничьте доступ к созданию и редактированию оповещений через IAM-политику.
- Убедитесь, что SNS Topic использует механизмы подтверждённых подписок и шифрование при необходимости.
Локальные советы для России и соседних регионов
- При тестировании учитывайте выбранный регион AWS (latency влияет на время доставки).
- Если ваша команда использует Email для уведомлений, проверьте спам-фильтры и политики почтового провайдера.
Заключение
В статье показано, как создать оповещение CloudWatch для метрики NumberOfMessagesSent у очередей SQS и отправлять уведомления в SNS. Мы также привели рекомендации по выбору статистики, периодов, тестированию, роли участников и краткий runbook для инцидентов. Используйте предложенные чеклисты и методологию для надёжного мониторинга очередей.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
