
Как диагностировать и улучшить производительность MySQL
Кратко: начните с оценки нагрузки сервера и логов медленных запросов, затем настраивайте буферы и индексы по мере необходимости. Используйте MySQLTuner, анализ EXPLAIN и системный мониторинг, делайте изменения поэтапно с бэкапом и измеряйте эффекты.
Быстрые ссылки
Устранение высокой нагрузки сервера
Настройка размеров буферов
Анализ медленных запросов
Роль индексов
Контроль изменений и проверка результата
В этом руководстве изложены практические шаги по расследованию проблем с производительностью MySQL. Каждая среда уникальна, поэтому советы даются в общем виде и дополняются приемами, чеклистами и планом действий.
Определения в одну строку
- Buffer pool — область памяти для кэширования страниц InnoDB.
- Slow query log — лог запросов, которые выполняются дольше порога.
- EXPLAIN — команда, показывающая план выполнения запроса.
Устранение высокой нагрузки сервера
Когда сервер заметно замедляется или стабильно использует много ресурсов, начните с системного и серверного аудита.
Шаги начального аудита:
- Посмотрите системные метрики: CPU, память, дисковые I/O, процент использования swap, количество активных соединений и latency дисковой подсистемы.
- Определите, растет ли нагрузка плавно или появляются пиковые всплески.
- Соберите метрики MySQL: QPS (queries per second), slow queries, open tables, connections, Innodb metrics.
Полезный быстрый инструмент для старта — MySQLTuner. Это скрипт на Perl, который выполняет список проверок конфигурации и выдает рекомендации.
Установка и запуск MySQLTuner:
wget http://mysqltuner.pl/ -O mysqltuner.plchmod +x mysqltuner.pl./mysqltuner.pl --host 127.0.0.1 --username root --pass mysql-passwordПодключайтесь как root, чтобы скрипт мог прочитать все необходимые переменные. MySQLTuner не меняет настройки автоматически — он лишь дает рекомендации.
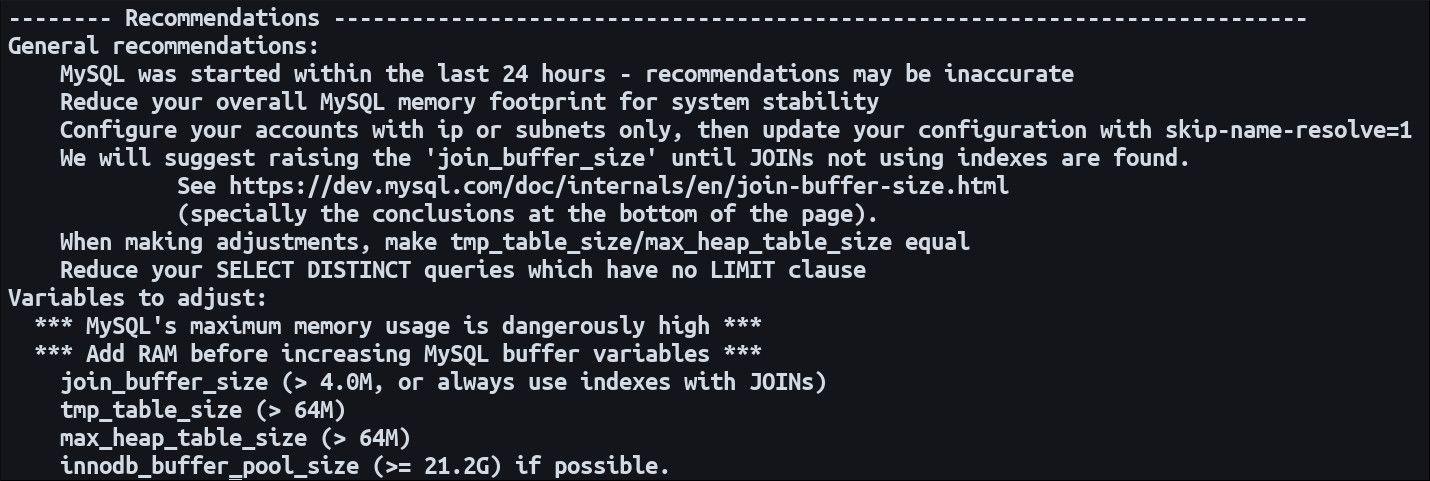
Важно: рекомендации MySQLTuner нужно рассматривать как отправную точку. Не все советы будут применимы к вашей нагрузке; некоторые могут ухудшить ситуацию.
После внесения изменений перезапустите сервер и наблюдайте за поведением системы. MySQLTuner советует оставить сервер под рабочей нагрузкой минимум 24 часа для точной оценки.
sudo /etc/init.d/mysql restartСоветы по системному мониторингу:
- Наблюдайте за swap: активная свопинговая активность обычно означает недостаток RAM.
- Посмотрите на дисковые очереди и латентность операций ввода/вывода.
- Оцените среднее время отклика на SELECT/INSERT/UPDATE.
- Отслеживайте хвостовые задержки, а не только медиану.
Настройка размеров буферов
Изменение размеров буферов может дать заметный эффект, особенно если сервер по умолчанию использует малые значения.
Формат записи величин в my.cnf: указывайте K, M, G, например 512M для 512 мегабайт.
Ключевые переменные и рекомендации:
- innodb_buffer_pool_size: обычно 70–80% доступной оперативной памяти на выделенном MySQL-сервере. Это основной кэш InnoDB.
- innodb_buffer_pool_instances: число инстансов буфера, 1–64. Большее значение помогает многопоточной работе на больших пулах.
- innodb_log_file_size: размер redo логов. Большие файлы улучшают write throughput, но увеличивают время восстановления после краха.
- key_buffer_size: кэш индексов для MyISAM. Если используете только InnoDB, оставьте маленькое значение, например 32M.
- join_buffer_size: буфер для соединений без индексов. Выделяется на каждое соединение/операцию JOIN, поэтому не увеличивайте чрезмерно.
- sort_buffer_size: буфер для сортировок через filesort; также выделяется на соединение.
Примерный фрагмент my.cnf для сервера с 32 GiB RAM, исключительно InnoDB (пример, адаптируйте под свою систему):
[mysqld]
innodb_buffer_pool_size = 24G
innodb_buffer_pool_instances = 8
innodb_log_file_size = 1G
innodb_flush_method = O_DIRECT
key_buffer_size = 32M
join_buffer_size = 512K
sort_buffer_size = 512K
max_connections = 500
Перед изменением innodb_log_file_size остановите сервер, переименуйте старые файлы ib_logfile* и только затем перезапустите MySQL, иначе сервер откажется стартовать.
Риски и предостережения:
- Слишком большие глобальные буферы могут привести к исчерпанию памяти, особенно если соединений много и многие переменные выделяются на соединение.
- Буферы, выделяемые на сессию (join_buffer_size, sort_buffer_size, read_buffer_size и т.д.), суммируются по активным соединениям. Учтите пиковое количество соединений.
- Изменяйте настройки по одной и контролируйте влияние.
Анализ медленных запросов
Лог медленных запросов показывает запросы, выполнение которых занимает дольше заданного порога.
Включение логов из mysql-shell:
sudo mysqlSET GLOBAL slow_query_log = 'ON';
SET GLOBAL slow_query_log_file = '/slow-query.log';
SET GLOBAL long_query_time = 5;Это будет логировать запросы дольше 5 секунд в файл /slow-query.log.
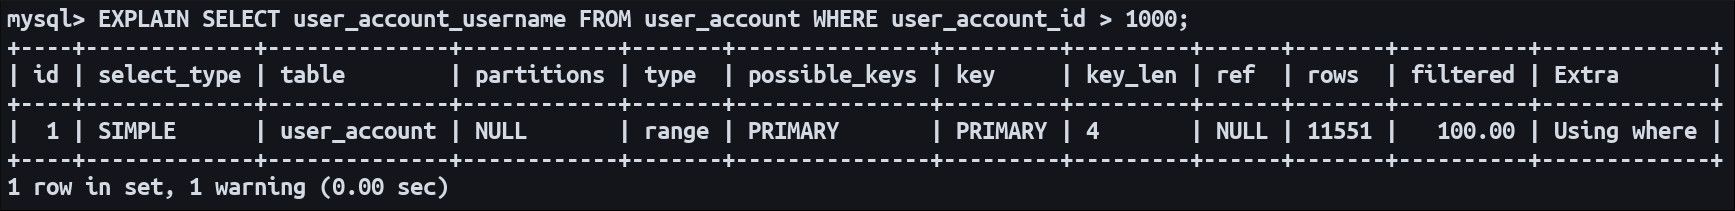
После того как вы нашли проблемные запросы, используйте EXPLAIN перед запросом, чтобы увидеть план выполнения:
EXPLAIN SELECT ...;EXPLAIN покажет, какие индексы используются, тип соединения (ALL, index, ref, eq_ref), количество строк для оценки и возможный порядок сканирования.
Ключевые поля EXPLAIN:
- id: идентификатор запроса/подзапроса,
- select_type: тип SELECT (SIMPLE, PRIMARY, SUBQUERY и т. п.),
- table: таблица, к которой применен шаг,
- type: тип доступа (ALL значит full table scan, range, ref, eq_ref это лучше),
- possible_keys: индекс(ы), которые могли бы примениться,
- key: индекс, который был выбран,
- rows: приблизительное число строк, прочитанных для этого шага,
- Extra: дополнительные указания, например “Using index” или “Using temporary; Using filesort”.
Используйте MySQL Workbench или другие визуальные инструменты для упрощения анализа EXPLAIN:
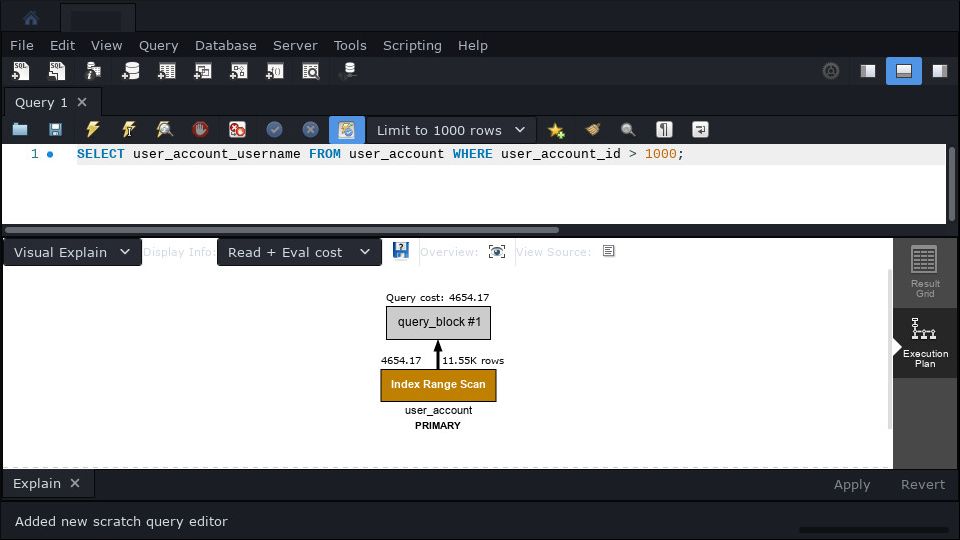
В Workbench можно быстро получить визуальный план с подсветкой операторов.
Полезные инструменты для глубокого анализа:
- pt-query-digest из Percona Toolkit — агрегирует slow log и выявляет самые дорогие запросы по времени и частоте.
- Performance Schema, Information Schema — для продвинутого мониторинга.
Роль индексов
Индексы — один из самых мощных способов ускорить запросы. Но неправильные индексы могут добавить накладные расходы на запись и хранение.
Пример простого запроса, который выигрывает от индекса:
SELECT * FROM users WHERE Email = 'example@example.com';Если на users.Email есть индекс, MySQL выполнит быстрый поиск; без индекса произойдет full table scan.
Создание индекса на поле:
ALTER TABLE my_table ADD INDEX my_index (my_field);После добавления индекса обновите статистику:
OPTIMIZE TABLE my_table;Покрывающий индекс (covering index) включает все поля, используемые в запросе, и может позволить избежать обращения к основным данным таблицы:
SELECT a, b FROM my_table WHERE x = 1 AND y = 2 ORDER BY z;
ALTER TABLE my_table ADD INDEX covering_index (x, y, z);
Порядок колонок в составном индексе имеет значение: индекс (x, y, z) эффективен для WHERE x=… AND y=… и ORDER BY z только в специфичных ситуациях.
Не индексируйте бездумно: каждый индекс увеличивает накладные расходы на INSERT/UPDATE/DELETE.
Лог запросов без индексов
Включите лог запросов без индексов, чтобы найти такие случаи:
SET GLOBAL log_queries_not_using_indexes = 'ON';Запросы без индекса будут попадать в slow query log независимо от порога long_query_time.
Методология расследования производительности — пошаговый мини-метод
- Сбор метрик системы и MySQL за последние часы или дни.
- Определение времени и характера деградации (постоянная или пиковая).
- Запуск MySQLTuner для быстрой проверки конфигурации.
- Включение slow log и логирования запросов без индексов.
- Агрегация slow log с помощью pt-query-digest и отбор наиболее затратных запросов.
- Для каждого проблемного запроса: EXPLAIN, просмотр индексов, предложение оптимизации (индекс/рефакторинг запроса/ограничение выборки).
- Настройка буферов и параметры InnoDB по мере необходимости.
- Тестирование изменений на нагрузочном стенде, затем постепенное развёртывание на проде.
- Мониторинг влияния и откат при ухудшении.
План действий при внесении изменений — SOP
- Сделать бэкап конфигурации my.cnf и текущих настроек:
mysqldump --all-databases --single-transaction > all_databases.sql
cp /etc/mysql/my.cnf /etc/mysql/my.cnf.bak- Внести изменения в конфиг по одному параметру.
- Перезапустить сервер и пометить время изменения.
- Наблюдать метрики 24 часа в штатной нагрузке.
- Если ухудшение, вернуть бэкап и перезапустить.
Критерии приёмки
- Среднее время ответа снижается на X в процентах по сравнению с базовой линией (измеряйте до изменений).
- Нет роста процента ошибок или количества отклонённых соединений.
- Пиковая нагрузка обрабатывается без свопа и с допустимой латентностью.
Примечание: не придумывайте чисел в SLA без базовой линии измерений — оценивайте относительно собственных метрик.
Руководство на случай инцидента при перегрузке
- Перекройте сторонние интеграции, если возможно, чтобы снизить нагрузку.
- Включите read-only режим для не критичных сервисов.
- Определите самые тяжёлые запросы с помощью pt-query-digest или performance_schema.
- Временные меры: уменьшите max_connections, снизьте innodb_buffer_pool_size только в крайнем случае, освободите swap.
- Если причина — поток бэчей или массовые запросы от ETL, приостановите их.
- После стабилизации разберите корневую причину и внедрите корректное решение.
Роль разработчиков и DBA — чеклисты по ролям
DBA:
- Оценить аппаратные ресурсы и предложить баланс памяти и параметров.
- Настроить мониторинг и логирование.
- Управлять изменениями конфигурации и откатом.
- Проводить регулярный аудит индексов.
Разработчик:
- Проверять запросы на предмет N+1 проблем.
- Использовать пагинацию вместо больших выборок.
- Профилировать ORM-генерируемые запросы.
- Предлагать индексные изменения с учётом паттернов запросов.
Системный админ:
- Следить за дисковой подсистемой и сетевой задержкой.
- Настраивать резервное копирование и процедуру восстановления.
Тесты и критерии приёмки
- Тест нагрузки: прогоните набор запросов, имитирующих пиковую нагрузку; сравните p95 латентность до и после изменений.
- Функциональные тесты: убедитесь, что структура индексов не меняет результаты запросов.
- Регрессионные тесты: прогоните ключевые сценарии приложения.
Как и когда индекс не поможет — примеры
- Фильтрация по полю с очень высокой кардинальностью, где запросы возвращают большую долю таблицы, может все равно требовать чтения значительной части таблицы.
- Частые обновления полей, по которым создаётся индекс, приведут к росту накладных расходов записи.
- Если узкое место в дисковой подсистеме или сети, индексы не устранят проблему I/O.
Советы по масштабированию
- Горизонтальное шардинг для очень больших таблиц, если индексы и вертикальное масштабирование исчерпаны.
- Репликация для распределения чтений: читайте с реплик, пишите на мастер.
- Кеширование на уровне приложения или Redis для горячих данных.
Матрица рисков и смягчение
- Риск: исчерпание памяти при неправильной настройке буферов. Смягчение: тестировать на стенде, применять изменения по одной переменной.
- Риск: ухудшение производительности из-за избыточных индексов. Смягчение: отслеживать нагрузку записи и размер таблиц.
- Риск: длительная генерация индекса на большой таблице. Смягчение: создавать индексы онлайн, по возможности, или в окно обслуживания.
Короткие команды и сниппеты для повседневных проверок
Посмотреть текущие глобальные переменные, связанные с InnoDB:
SHOW GLOBAL STATUS LIKE 'Innodb%';
SHOW VARIABLES LIKE 'innodb%';
Проверить активные соединения и их состояние:
SHOW PROCESSLIST;Анализ долгих запросов за сутки с помощью pt-query-digest:
pt-query-digest /slow-query.log > slow-report.txtМиграции и совместимость
- При переходе между версиями MySQL проверяйте изменения поведения optimizer и новые переменные конфигурации.
- Тестируйте EXPLAIN для критичных запросов после апгрейда движка.
Краткая памятка по безопасности и конфиденциальности
- Логи медленных запросов могут содержать чувствительные данные. Ограничьте доступ к файлам логов и донорам.
- Убедитесь, что бэкапы шифруются и хранятся в безопасном месте.
1-строчная глоссарная подборка
- InnoDB: основной транзакционный движок в MySQL.
- MyISAM: старый движок без транзакций, индексируется через key_buffer.
- EXPLAIN: план выполнения запроса.
Decision flowchart
flowchart TD
  A[Начальная проверка сервера] --> B{Высокая загрузка CPU/IO?}
  B -- Да --> C[Проанализировать процессы и slow log]
  B -- Нет --> D[Проанализировать приложение и N+1]
  C --> E{Проблема в конфигурации?}
  E -- Да --> F[Применить мелкие изменения и мониторить]
  E -- Нет --> G[Оптимизация запросов и индексов]
  D --> G
  F --> H[Оставить под нагрузкой 24 часа]
  G --> H
  H --> I[Если улучшение - закрепить, иначе откат]
Короткая социальная превью версия
MySQL под нагрузкой? Этот практический чеклист поможет найти узкие места: от MySQLTuner и slow log до EXPLAIN и индексов. Шаги для безопасных изменений и план отката.
Короткое объявление 100–200 слов
Если ваша база MySQL стала медленной, начните с системного мониторинга и логов медленных запросов. Используйте MySQLTuner для быстрой оценки конфигурации, включите slow_query_log и log_queries_not_using_indexes, затем агрегируйте данные pt-query-digest. Для проблемных запросов применяйте EXPLAIN и добавляйте индексы осмысленно. Меняйте параметры памяти по одному, делайте бэкап и тестируйте в нагрузке. Прикидка: innodb_buffer_pool_size обычно 70–80% RAM на выделенном сервере, но корректируйте значение под реальную нагрузку. Резервное копирование, мониторинг и чеклист ролей помогут избежать регрессий.
Итог
Основные выводы:
- Всегда начинайте с мониторинга системы и логов перед изменением конфигурации.
- Индексы и размеры буферов часто дают наибольший эффект, но требуют аккуратности.
- Делайте изменения по одному, тестируйте и держите план отката.
Важно
Нельзя дать универсальное решение — каждая система уникальна. Используйте предложенные методы, чтобы выработать собственную последовательность расследования и улучшения.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
