
Установка Elasticsearch на кластер из 3 узлов (Ubuntu 18.04)
Коротко: пошаговая инструкция по развертыванию кластера Elasticsearch из трёх узлов на Ubuntu 18.04. Описаны скачивание, установка OpenJDK 8, конфигурация файлов, запуск и базовая проверка кластера.
Elasticsearch — это распределённый движок для полнотекстового поиска и аналитики. Он относится к семейству NoSQL-хранилищ и умеет эффективно индексировать структурированные и неструктурированные данные. Elasticsearch предоставляет простой REST API для управления кластером, записи и поиска данных.
Короткое определение: Elasticsearch — сервер для быстрого поиска и аналитики данных через REST.
Краткие требования
- Операционная система: Ubuntu 18.04 LTS
- Java: OpenJDK 8 (Elasticsearch 7.4.2 включает совместимость с Java 8)
- Сеть: доступность портов 9200 (HTTP) и 9300 (кросс-узловая связь)
Что мы сделаем
- Скачиваем архив Elasticsearch
- Устанавливаем Java 1.8
- Устанавливаем и настраиваем конфигурацию Elasticsearch на трёх узлах
- Запускаем кластер и проверяем статус
Скачивание Elasticsearch
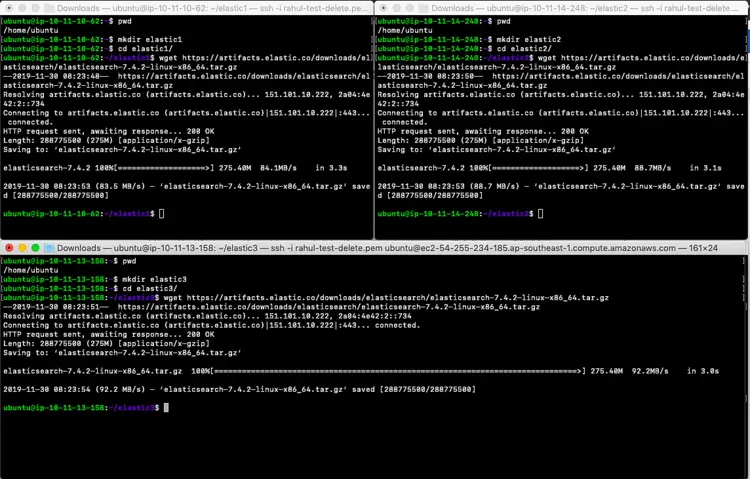
Для Linux текущая версия в примере — 7.4.2. На каждом узле выполните следующие команды (имя папки на узле может отличаться):
mkdir elastic1
cd elastic1/
wget https://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-7.4.2-linux-x86_64.tar.gz
Важно: если вам нужна другая версия, выберите её в архивах на сайте elastic.co. Рекомендуется использовать актуальную ветку с исправлениями безопасности.
Установка Java
Elasticsearch требует наличия JVM. В примере используем OpenJDK 8.
На каждом узле выполните:
sudo apt update
sudo apt install openjdk-8-jdk
java --version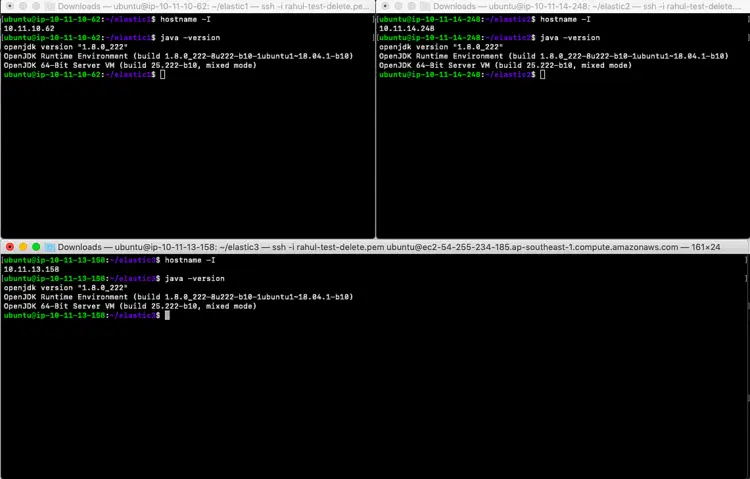
Установка и распаковка Elasticsearch
Распакуйте скачанный архив на каждом узле:
tar -zxvf elasticsearch-7.4.2-linux-x86_64.tar.gz
Настройка Elasticsearch для кластерного режима
В примере мы используем три сервера с приватными IP:
- es-node-1: 10.11.10.62 (инициирующий мастер)
- es-node-2: 10.11.14.248
- es-node-3: 10.11.13.158
Откройте файл конфигурации config/elasticsearch.yml и внесите изменения, указав IP ваших узлов:
vim config/elasticsearch.yml
Конфигурация на master es-node-1
Вставьте в config/elasticsearch.yml следующие параметры (проверьте IP):
#give your cluster a name.
cluster.name: my-cluster

#give your nodes a name (change node number from node to node).
node.name: "es-node-1"

#define node 1 as master-eligible:
node.master: true

#define nodes 2 and 3 as data nodes:
node.data: true

#enter the private IP and port of your node:
network.host: 10.11.10.62
http.port: 9200

#detail the private IPs of your nodes:
discovery.zen.ping.unicast.hosts: ["10.11.10.62", "10.11.14.248","10.11.13.158"]

cluster.initial_master_nodes:
- 10.11.10.62
Важно: параметр cluster.initial_master_nodes указывается только при первом запуске кластера для ускоренного выбора начального мастера.
Конфигурация на es-node-2
Вставьте в config/elasticsearch.yml следующие параметры (без cluster.initial_master_nodes):
#give your cluster a name.
cluster.name: my-cluster

#give your nodes a name (change node number from node to node).
node.name: "es-node-2"

#define node 1 as master-eligible:
node.master: true

#define nodes 2 and 3 as data nodes:
node.data: true

#enter the private IP and port of your node:
network.host: 10.11.14.248
http.port: 9200

#detail the private IPs of your nodes:
discovery.zen.ping.unicast.hosts: ["10.11.10.62", "10.11.14.248","10.11.13.158"]
Конфигурация на es-node-3
Вставьте в config/elasticsearch.yml следующие параметры (без cluster.initial_master_nodes):
#give your cluster a name.
cluster.name: my-cluster

#give your nodes a name (change node number from node to node).
node.name: "es-node-3"

#define node 1 as master-eligible:
node.master: true

#define nodes 2 and 3 as data nodes:
node.data: true

#enter the private IP and port of your node:
network.host: 10.11.13.158
http.port: 9200

#detail the private IPs of your nodes:
discovery.zen.ping.unicast.hosts: ["10.11.10.62", "10.11.14.248","10.11.13.158"]
Запуск кластера и базовая проверка
Запуск Elasticsearch
На каждом узле (сначала запустите master es-node-1) можно стартовать Elasticsearch в foreground для отладки:
bin/elasticsearchВажно: по умолчанию Elasticsearch использует mmapfs для хранения индексов. Системный лимит vm.max_map_count часто слишком низок и вызывает ошибку OOM:
[1]: max virtual memory areas vm.max_map_count [65530] is too low, increase to at least [262144]На Ubuntu 18.04 временно увеличьте лимит так (от root/sudo):
sudo sysctl -w vm.max_map_count=262144Чтобы запустить в фоне, добавьте флаг -d:
bin/elasticsearch -d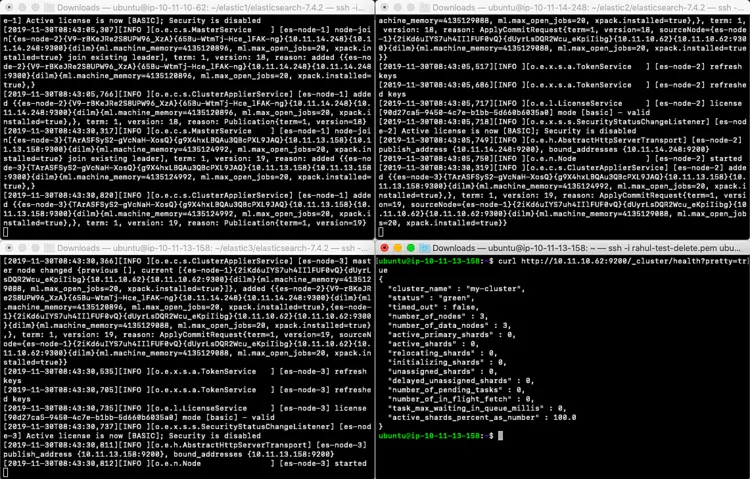
После старта master вы увидите в логах сообщения о присоединении узлов. Примеры логов ниже иллюстрируют, как es-node-2 и es-node-3 добавляются в кластер:
[2019-11-30T08:43:05,766][INFO ][o.e.c.s.ClusterApplierService] *[es-node-1] added {{es-node-2}*{V9-rBKeJRe2S8UPW96_XzA}{65Bu-WtmTj-Hce_lFAK-ng}{10.11.14.248}{10.11.14.248:9300}{dilm}{ml.machine_memory=4135120896, ml.max_open_jobs=20, xpack.installed=true},}, term: 1, version: 18, reason: Publication{term=1, version=18}[2019-11-30T08:43:30,317][INFO ][o.e.c.s.MasterService ] *[es-node-1] node-join[{es-node-3*}{TArASFSyS2-gVcNaH-XosQ}{g9X4hxLBQAu3QBcPXL9JAQ}{10.11.13.158}{10.11.13.158:9300}{dilm}{ml.machine_memory=4135124992, ml.max_open_jobs=20, xpack.installed=true} join existing leader], term: 1, version: 19, reason: added {{es-node-3}{TArASFSyS2-gVcNaH-XosQ}{g9X4hxLBQAu3QBcPXL9JAQ}{10.11.13.158}{10.11.13.158:9300}{dilm}{ml.machine_memory=4135124992, ml.max_open_jobs=20, xpack.installed=true},}[2019-11-30T08:43:30,820][INFO ][o.e.c.s.ClusterApplierService] [es-node-1] added {{es-node-3}{TArASFSyS2-gVcNaH-XosQ}{g9X4hxLBQAu3QBcPXL9JAQ}{10.11.13.158}{10.11.13.158:9300}{dilm}{ml.machine_memory=4135124992, ml.max_open_jobs=20, xpack.installed=true},}, term: 1, version: 19, reason: Publication{term=1, version:19Проверка состояния кластера
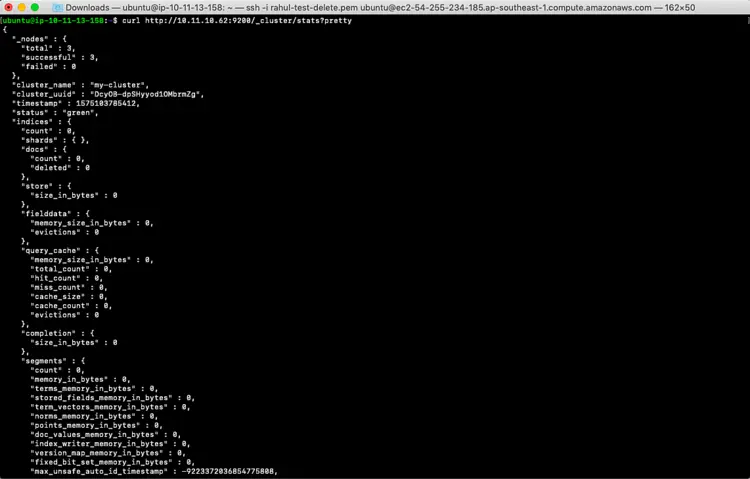
С терминала, с которого доступен 10.11.10.62, выполните:
curl http://10.11.10.62:9200/_cluster/stats?pretty
curl http://10.11.10.62:9200/_nodes/process?pretty
Повторный вызов _cluster/stats покажет статус кластера и количество узлов.
Фактбокс — ключевые параметры
- Версия примера: 7.4.2
- Java: OpenJDK 8
- HTTP порт: 9200
- Транспортный порт: 9300
- Рекомендуемая vm.max_map_count: 262144
Когда это не подходит
- Если необходимо транзакционное хранилище ACID с жёсткими гарантиями, Elasticsearch — не лучший выбор.
- Для очень больших OLTP-нагрузок реляционные СУБД или специализированные хранилища лучше подходят.
Мини-плейбук для развёртывания (SOP)
- Подготовьте 3 Ubuntu 18.04 ВМ с корректной сетевой связью.
- На всех узлах установите OpenJDK 8.
- Скачайте и распакуйте один и тот же бинарник Elasticsearch.
- Отредактируйте config/elasticsearch.yml с правильными IP.
- На master-узле укажите cluster.initial_master_nodes только при первом старте.
- Установите vm.max_map_count и запустите master в фоне.
- Последовательно запустите остальные узлы и проверьте _cluster/stats.
Чеклист по ролям
Администратор:
- Проверил сетевые правила и доступность 9200/9300
- Настроил vm.max_map_count
- Настроил системную безопасность (firewall)
Оператор:
- Запустил демоны Elasticsearch
- Отслеживает логи и состояние индексов
Разработчик:
- Проверяет доступность REST API
- Тестирует индексацию и поиск
Быстрый набор команд (cheat sheet)
# Установка Java
sudo apt update
sudo apt install openjdk-8-jdk

# Установка vm.max_map_count
sudo sysctl -w vm.max_map_count=262144

# Распаковка и запуск
tar -zxvf elasticsearch-7.4.2-linux-x86_64.tar.gz
cd elasticsearch-7.4.2/
bin/elasticsearch -d

# Проверка
curl http://10.11.10.62:9200/_cluster/stats?pretty
Диагностика и распространённые проблемы
Проблема: узлы не видят друг друга
- Проверьте доступность порта 9300 между машинами
- Проверьте правильность списка discovery.zen.ping.unicast.hosts
Проблема: кластер не может выбрать мастер
- Убедитесь, что cluster.initial_master_nodes задан корректно при первом старте
- Проверьте версии Elasticsearch — узлы в кластере должны использовать совместимые версии
Проблема: недостаток vm.max_map_count
- Установите vm.max_map_count=262144 или выше
Диаграмма принятия решений для ролей узлов
flowchart TD
  A[Нужен мастер?] -->|Да| B[Сделать node.master: true]
  A -->|Нет| C[Сделать node.master: false]
  B --> D[Является ли узел data?]
  C --> D
  D -->|Да| E[Установить node.data: true]
  D -->|Нет| F[Установить node.data: false]
Критерии приёмки
- Все три узла отображаются в выводе _cluster/stats
- Индекс создаётся и документ может быть получен по ID
- Логи не содержат ошибок уровня ERROR/SEVERE
Безопасность и рекомендации
- По умолчанию HTTP интерфейс открыт на 9200. Разверните прокси или включите TLS/аутентификацию для рабочего окружения.
- На рабочих кластерах используйте механизм безопасности Elastic (X-Pack) или внешнюю систему аутентификации.
- Ограничьте доступ к 9300 только внутри доверенной сети.
Итог
Мы прошли шаги от скачивания до базовой проверки трёхузлового кластера Elasticsearch на Ubuntu 18.04. После успешной базовой настройки следует настроить резервное копирование, мониторинг и безопасность перед выводом в продуктив.
Важно: это базовая инструкция. Для продакшен-развёртывания изучите официальную документацию Elasticsearch и требования по безопасности и масштабированию.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
