
Балансировка нагрузки и проксирование в NGINX
Быстрые ссылки
- Как работает балансировка нагрузки в NGINX
- Проксирование на бэкенд
NGINX часто используется как веб‑сервер, но он же отлично справляется с ролью обратного прокси и балансировщика нагрузки — сетевого компонента, принимающего трафик и перенаправляющего запросы на несколько серверов приложения.
Как работает балансировка нагрузки в NGINX
Ключевая идея балансировщика нагрузки — он находится между пользователем и группой серверов и проксирует запросы на эти серверы. Обычно в пуле два и более серверов, чтобы трафик можно было равномерно распределять.
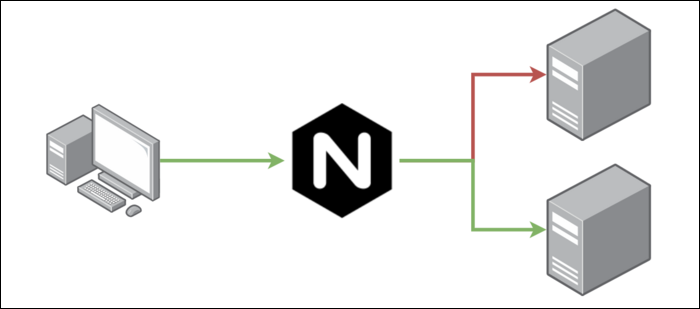
Определяющим в конфигурации является способ выбора сервера. По умолчанию используется round‑robin — NGINX последовательно отправляет запросы на каждый сервер, что обеспечивает приблизительно равномерную нагрузку.
Определения (в одну строку):
- upstream — перечисление серверов, к которым NGINX может проксировать трафик.
- round‑robin — последовательное распределение запросов по списку серверов.
- ip_hash — алгоритм привязки клиента к серверу по IP для обеспечения устойчивой сессии.
Однако на практике всё сложнее: многим приложениям нужна сохранность сессии (session persistence). Например, корзина покупок может храниться локально на одном сервере приложения; при переключении сервера середине сессии пользователь может увидеть неконсистентное состояние. Многие такие проблемы решаются централизованными хранилищами (Redis, базы данных), но привязка сессии по‑прежнему востребована.
В NGINX список серверов называется upstream и конфигурируется как перечисление адресов:
upstream backend {
    server backend1.example.com weight=5;
    server backend2.example.com;
}
Здесь задан параметр weight — приоритет сервера (полезно, если сервера разного размера). Для upstream доступны и другие опции: max_conns, различные таймауты. В коммерческой версии NGINX Plus можно настроить health checks, чтобы трафик не отправлялся на нездоровые инстансы.
Самая простая форма привязки сессии — ip_hash. NGINX использует IP клиента, чтобы идентифицировать пользователя и закрепить его за одним сервером:
upstream backend {
    ip_hash;
    server backend1.example.com;
    server backend2.example.com;
}
IP‑hash обязателен для сокет‑ориентированных приложений и всего, что требует постоянного соединения. Если нельзя полагаться на IP (например, клиенты за NAT или через прокси), можно настроить собственный хеш по заголовку или URI:
upstream backend {
    hash $scheme$request_uri consistent;
    server backend1.example.com;
    server backend2.example.com;
}
Если сессии не важны, можно выбрать более «умный» round‑robin, учитывающий текущие подключения:
upstream backend {
    least_conn;
    server backend1.example.com;
    server backend2.example.com;
}
Или ориентироваться на скорость отклика сервера:
upstream backend {
    least_time header;
    server backend1.example.com;
    server backend2.example.com;
}
NGINX Plus предлагает дополнительные варианты persistence и health checks, но ip_hash покрывает большинство сценариев.
Проксирование на бэкенд
Когда upstream настроен, отправляйте запросы к нему внутри location блоков с помощью proxy_pass:
server {
    listen 80;
    server_name example.com;

    location / {
        proxy_pass http://backend;
    }
}
Если вы используете HTTPS между клиентом и NGINX или между NGINX и бэкендом, настройте SSL:
server {
    listen 443 ssl;
    server_name example.com;

    ssl_certificate /etc/ssl/certs/server.crt;
    ssl_certificate_key /etc/ssl/certs/server.key;
    ssl_client_certificate /etc/ssl/certs/ca.crt;

    location / {
        proxy_pass https://backend;
    }
}
Важно: при проксировании HTTPS не забудьте про настройку проверки сертификатов, SNI и заголовков, если бэкенд ожидает оригинальный Host или другую информацию.
Когда привязка сессии не подойдёт (примеры отказа)
- Клиенты за общим NAT: разные пользователи могут получить один видимый IP, и ip_hash приведёт к коллизиям.
- Горизонтальное масштабирование и кратковременные инстансы: при частой смене инстансов привязка по IP приведёт к нестабильности.
- Приложение, которое уже хранит состояние в централизованном хранилище — привязка не нужна и усложнит балансировку.
Альтернативные подходы
- Централизованные сессии: Redis, Memcached, БД — снимают необходимость в session persistence на уровне балансировщика.
- Специфические балансировщики: HAProxy даёт продвинутые опции балансировки и мониторинга; облачные LB (AWS ALB/ELB, GCP Load Balancer) удобны для интеграции с автоскейлингом.
Практические советы и эвристики
- Если клиенты незащищённые (много NAT), избегайте ip_hash.
- Для разного железа используйте weight, но контролируйте max_conns.
- Вставляйте health checks (NGINX Plus или внешний монитор) — лучше отказоустойчивость.
- Для веб‑приложений чаще всего хватает least_conn или round‑robin с правильными timeouts.
Безопасность и харднинг (рекомендации)
- Всегда terminate TLS или используйте TLS до бэкенда при необходимости. Проверьте сертификаты и SNI.
- Не перенаправляйте чувствительные заголовки без фильтрации: используйте proxy_hide_header и proxy_set_header.
- Ограничивайте количество подключений и скорость: limit_conn, limit_req.
- Настройте таймауты proxy_connect_timeout, proxy_send_timeout и proxy_read_timeout, чтобы уязвимости типа slowloris не вешали процессы.
Важно: защищайте административные интерфейсы бэкендов и следите за логами ошибок.
Контрольные списки по ролям
DevOps:
- Проверить upstream на health checks.
- Настроить limit_conn/limit_req и таймауты.
- Включить логирование ошибок и access лог с метками бэкенда.
Разработчик приложения:
- Перенести состояние в централизованное хранилище, если возможно.
- Не полагаться на IP клиента для идентификации сессии.
Инженер по безопасности:
- Настроить TLS, проверку сертификатов и HSTS по необходимости.
- Убедиться, что proxy не раскрывает внутренних заголовков и инфраструктуры.
Чеклист при развертывании (минимальный)
- Сконфигурирован upstream с нужным алгоритмом.
- Настроены таймауты и ограничения соединений.
- SSL/TLS настроен для внешних соединений.
- Логи собираются и анализируются.
- Добавлены health checks или внешний мониторинг.
Критерии приёмки
- Клиентские запросы распределяются без ошибок 5xx при нормальной нагрузке.
- Сессии сохраняются (если требуется) и не теряются при обычном апдейте бэкендов.
- Система восстанавливает работоспособность при падении одного из бэкендов.
Короткая методология тестирования
- Поднять две реальных VM/контейнера с простым приложением.
- Настроить upstream с round‑robin и выполнить нагрузочный тест (ab, wrk).
- Повторить с least_conn и ip_hash; сравнить поведение сессий.
- Отключить один из бэкендов и проверить, что запросы корректно перенаправляются.
Сводка
NGINX — гибкий инструмент для балансировки нагрузки и проксирования. Выбор алгоритма (round‑robin, least_conn, ip_hash, hash) зависит от приложения и сетевой топологии. При правильной настройке таймаутов, лимитов и безопасности NGINX обеспечивает устойчивую и предсказуемую маршрутизацию трафика.
Важно: если сохранение сессии критично, рассмотрите перенос состояния в централизованное хранилище вместо постоянной привязки по IP.
Ключевые шаги: определить требования к сессиям, выбрать алгоритм upstream, настроить таймауты/лимиты и включить мониторинг.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
