
Как оставаться онлайн при сбоях облака: практические решения и план действий
Когда облако падает — останавливается всё
20 октября 2025 г. крупный сбой в регионе US-EAST-1 AWS показал, насколько хрупкой стала наша цифровая жизнь. Отказ мониторинга сети привёл к проблемам с разрешением DNS для DynamoDB, что запустило каскад отказов в EC2, Lambda и SQS и затронуло более 2 500 сервисов по всему миру.
Краткое определение терминов (в одну строку каждый):
- DynamoDB — распределённая NoSQL-база данных AWS.
- EC2 — виртуальные серверы в облаке AWS.
- Lambda — бессерверная платформа для запуска кода по событиям.
- SQS — сервис очередей сообщений для надёжной передачи данных.
Экономические и операционные последствия были значительными: Amazon, по оценкам, терял около $72 млн долларов в час. Отдельные отчёты (New Relic и отраслевые обзоры) на момент инцидента указывали, что для крупных фирм стоимость простоя может достигать миллионов долларов в час. Для обычных пользователей это вылилось в нерабочие банковские операции, недоступные умные устройства и прерванную работу.
Важно: такие сбои — не случайность, а выражение архитектурной концентрации трафика и сервисов у нескольких крупных провайдеров.
Важно: отказ в одном регионе может распространиться через зависимости между сервисами. Планируйте резервы заранее.
Почему интернет ломается системно
Концентрация трафика и сервисов в руках нескольких крупных компаний создаёт одиночные точки отказа. AWS контролирует около 30% глобального рынка облаков; Google Cloud и Microsoft Azure тоже занимают значительную долю. Многие приложения и платформы направляют львиную долю трафика через регионы вроде US-EAST-1.
Последствия распространения отказа видны сразу: платежные шлюзы, игровые серверы, банковские приложения и сервисы для удалённой работы взаимозависимы. Несмотря на общее снижение числа инцидентов по годам, их стоимость растёт — для крупных компаний она может быть астрономической. Это означает: улучшения в надежности идут рука об руку с увеличением потерь при редких, но больших сбоях.
Ключевая мысль: «удобство = риск», если нет планов резервирования.
Как облачное удобство захватывает пользователей
Удобные облачные сервисы создают ощущение, что всё работает само собой — до первого сбоя. Вы используете Slack, Trello, Alexa, Zoom — но вы не владеете серверами, которые их поддерживают. Один сбой — и привычные процессы останавливаются.

Последствия для обычного пользователя: потеря доступа к общим документам, неподключённые умные устройства, прерванные онлайн-платежи. В прошлых инцидентах сообщалось о сотнях миллионов IoT-устройств, потенциально затронутых отказами. Локальные/оффлайн-решения дают контроль и снижают зависимость, не требуя полного отказа от облака.
Как оставаться онлайн, когда облако падает
Ниже — практическая пошаговая инструкция и набор инструментов. Я разделил рекомендации по уровню сложности и по ролям.
1. Переход на локально-ориентированные приложения (local-first)
Понятие: local-first — приложения, где данные первично обрабатываются локально и синхронизируются при доступе в сеть.
Почему это работает: при сбое облака локальная копия остаётся доступной, вы продолжаете работу и синхронизируете изменения позже.
Инструменты и примеры:
- Syncthing — пиринговый обмен файлами между вашими устройствами.
- Obsidian, Joplin — заметки, работающие оффлайн с опцией синхронизации.
- Matrix / Element — децентрализованный чат, который можно хостить на своем сервере.
- LibreOffice, OnlyOffice — документы без постоянной облачной привязки.
Как внедрить:
- Определите, какие рабочие потоки требуют синхронизации.
- Настройте Syncthing между рабочим ПК и ноутбуком.
- Перенесите личные заметки в Obsidian или Joplin и настроьте локальное хранилище.
- Тестируйте: отключите интернет и убедитесь, что рабочий процесс остаётся доступным.
Когда не работает: если вы полностью завязаны на серверные функции (например, облачные БД без локальной кеширования), local-first поможет лишь частично.
2. Включите офлайн-режимы и локальные копии в облако-зависимых сервисах
Практика для тех, кто не готов полностью отказываться от популярных SaaS.
Шаги:
- Экспортируйте данные ежедневно или настройте автоматические бэкапы (ежедневно/ежечасно в зависимости от критичности).
- Включите офлайн-режимы в Google Docs, Gmail, Spotify и пр.
- Для Trello/Notion настройте регулярные экспорты JSON/HTML и храните их локально.
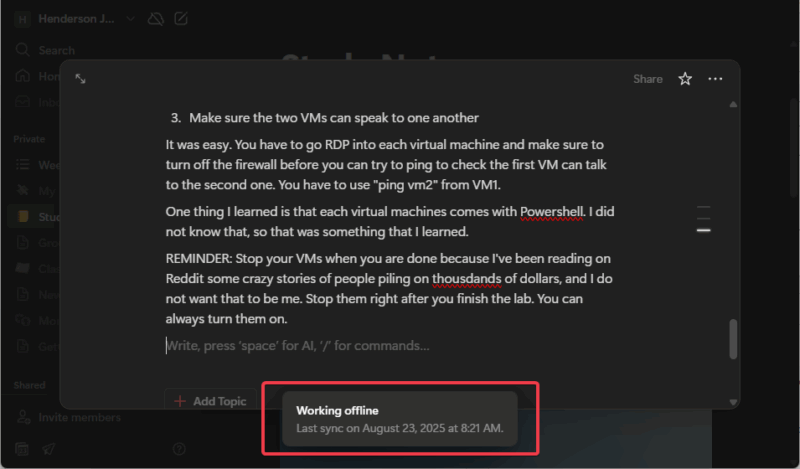
Пример: пользователи Notion, которые вели локальные резервные копии перед вторым инцидентом AWS, смогли продолжить работу без задержек. Это не замена, но разгружает критические моменты.
3. Локальное управление умным домом
Проблема: большинство голосовых ассистентов и смарт-устройств полагаются на облако. Решение — локальные контроллеры.
Рекомендации:
- Home Assistant на Raspberry Pi — полноценный центр домашней автоматизации, который работает автономно.
- Zigbee/ Z-Wave для локального управления освещением и замками.
- Hubitat и Apple HomeKit (с локальными хабами) — более приватные варианты.
Пример внедрения:
- Купите Raspberry Pi и установите Home Assistant.
- Подключите USB Zigbee-координатор (например, ConBee II).
- Мигрируйте основные сценарии (освещение, двери) в локальные автоматизации.
Когда DIY не подходит: если вам нужны облачные функции провайдерских сервисов (например, распознавание речи в облаке), локальные решения дадут автономность, но могут потерять часть функционала.
4. Гибридные бэкапы и локальные NAS
Идея: иметь локальную полную копию данных + оффсайт копию в другом облаке или S3.
Инструменты:
- Synology, QNAP для домашнего/офисного NAS.
- Nextcloud — мини-облако, хостимое локально.
- Используйте S3 (или альтернативный облачный архив) как вторичный репозиторий.
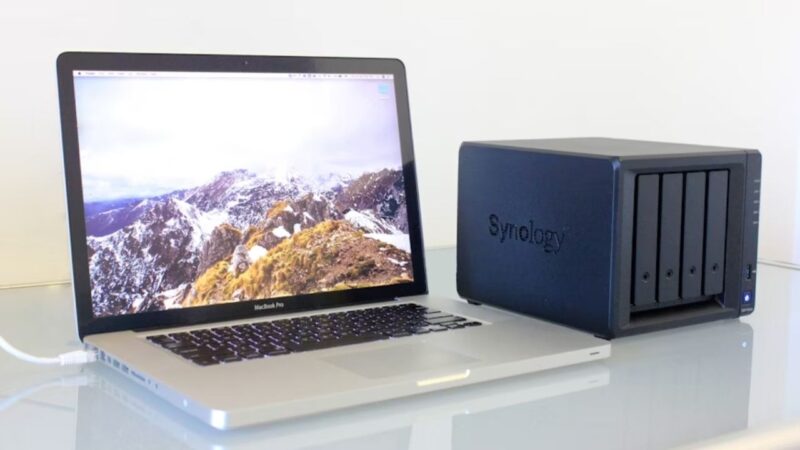
Пример плана:
- Настройте ежедневную зеркальную копию рабочих файлов на NAS.
- Настройте периодическую репликацию критичных архивов в S3 или другой облачный провайдер, отличающийся от основного.
- Тестируйте восстановление раз в месяц.
5. Разнообразьте провайдеров и зоны доступности
Для бизнеса: используйте multi-cloud и multi-region стратегии. Для пользователя: храните критичные данные в двух местах (локально + альтернативный облак).
Советы:
- Не полагайтесь на одну точку синхронизации.
- Используйте DNS с поддержкой failover и health checks.
- Для веб-приложений — репликация БД и независимые очереди сообщений.
Мини-методология внедрения устойчивости (четыре шага)
- Оцените: инвентаризируйте зависимости и критичность данных.
- Приоритизируйте: какие сервисы должны работать офлайн в первую очередь.
- Внедрите: local-first, бэкапы, NAS, Home Assistant.
- Тестируйте и мониторьте: регулярные drills и восстановление по сценарию.
Роль‑ориентированные чеклисты
Для конечного пользователя:
- Экспортируйте важные документы и контакты.
- Включите офлайн-доступ в почте и документах.
- Настройте локальное хранилище на внешнем диске или NAS.
- Установите минимум один local-first инструмент для заметок и файлов.
Для системного администратора / DevOps:
- Инвентаризируйте зависимости сервисов (DB, очереди, DNS).
- Настройте репликацию в разных регионах и multi-cloud.
- Реализуйте health checks и автоматический failover.
- Проводите учения по восстановлению и документируйте runbooks.
Для владельца малого бизнеса:
- Определите RTO (Recovery Time Objective) и RPO (Recovery Point Objective).
- Настройте гибридные бэкапы и локальные копии ключевых CRM/бухгалтерии.
- Подготовьте офлайн-процессы для платежей и коммуникаций.
Схема действий при обнаружении сбоя (decision tree)
flowchart TD
  A[Обнаружен сбой облака] --> B{Критичность сервиса}
  B -->|Критично| C[Переключиться на локальные копии и офлайн-инструменты]
  B -->|Не критично| D[Ожидать восстановления, продолжая мониторинг]
  C --> E{Есть ли автоматический failover?}
  E -->|Да| F[Мониторинг статуса и логирование]
  E -->|Нет| G[Запустить ручные процедуры: локальные бэкапы, альтернативные провайдеры]
  G --> H[Уведомить пользователей и записать пост-инцидентный отчёт]
  F --> H
  D --> H
Шаблон: ежедневный чеклист для устойчивости (пример)
- Убедиться, что локальные бэкапы завершились успешно.
- Проверить статус репликации NAS → облако.
- Обновить экспорт критичных баз данных (ежедневно для транзакционных систем).
- Выполнить smoke-тесты офлайн-функциональности.
Когда эти подходы не помогут — галерея крайних случаев
- Полные региональные отказы, затрагивающие несколько провайдеров одновременно (редко, но возможно).
- Сценарии, где бизнес-логика и интеграции требуют централизованной облачной обработки в реальном времени (например, глобальные платежные шлюзы).
- Устройства с закрытым прошивкой, которые нельзя перепрошить для работы локально.
Критерии приёмки
- RTO и RPO задокументированы и соблюдаются в 90% тестов.
- Локальные копии доступны и актуальны не старше заявленного RPO.
- Пользовательские сценарии (отправка письма, открытие документа, управление умным замком) работают в офлайн-режиме.
Факт‑бокс: ключевые числа и факты
- Дата крупного инцидента: 20 октября 2025 г.
- Затронуто сервисов: более 2 500.
- Оценка потерь Amazon: около $72 млн в час.
- Оценка стоимости простоя для крупных фирм по отраслевым отчётам: до $2 млн в час.
- Рыночная доля AWS: примерно 30% глобального облачного рынка.
Риски и смягчение
- Риск: потеря функционала при переходе на локальные решения. Смягчение: гибридный подход — хранить критичные функции локально, синхронизировать в облако.
- Риск: человеческая ошибка при ручных бэкапах. Смягчение: автоматизация и регулярные тесты восстановления.
Короткое объявление для команды (100–200 слов)
Короткая версия для информирования сотрудников или клиентов:
Обнаружен риск зависимости от единого облачного провайдера. Мы внедряeм стратегию устойчивости: ежедневные локальные бэкапы, офлайн-режимы для ключевых инструментов и тесты восстановления. Это позволит продолжать работу при региональных сбоях облака и снизит риски простоев. Просим вас экспортировать важные документы и следовать инструкциям IT: включить офлайн-доступ для почты и документов. IT-команда проведёт пресс‑драйв восстановления в течение месяца. Цель — обеспечить непрерывность работы и защитить данные.
Итог и следующиe шаги
- Проведите аудит зависимостей — что потеряет работоспособность при сбое облака.
- Внедрите минимум одну local-first замену для ключевого процесса.
- Настройте гибридные бэкапы (NAS + облако другой провайдер).
- Протестируйте recovery plan и обновляйте его регулярно.
Кратко: вы не сможете предотвратить все сбои, но можете минимизировать их влияние. Аудитируйте свою инфраструктуру сегодня — и верните контроль над своими данными и устройствами.
Вопросы и ответы
Q: Хватит ли просто сохранять копии на внешнем диске?
A: Это лучше, чем ничего, но внешний диск может быть недоступен при пожаре, краже или удалённом доступе; NAS с репликацией в облако — более устойчивое решение.
Q: Стоит ли полностью уходить из AWS?
A: Полный уход не всегда оправдан; более практично — диверсифицировать и иметь локальные резервные механизмы.
Q: Как часто тестировать восстановление?
A: Минимум раз в квартал; для критичных сервисов — ежемесячно.

Похожие материалы

Несколько аккаунтов Skype: Multi Skype Launcher

Журнал для работы: повысить продуктивность

Персональные звуки уведомлений на Android

Скачивание шоу Hulu для офлайн‑просмотра

Microsoft Start: персонализированная новостная лента
